 DeepSeekFlash, offene Gewichte
DeepSeek V4.1
DeepSeeks schnelles Modell mit offenen Gewichten und Vision für kostengünstige tägliche Aufgaben.
Erstellt auf Runable
Jeder Clip ist ein Prompt, der als einzelne Runable-Aufgabe ausgeführt wird.
DeepSeek 4.1 auf Runable
Blitzschnelle Ergebnisse
Etwa 206 Token pro Sekunde bei Seiten, Skripten und Entwürfen.
Liest Bilder
Übergib einfach Screenshots, Produktfotos oder Diagramme.
Mit Premium kombinieren
Entwürfe mit DeepSeek, Fertigstellung mit Opus 5.5.
So nutzen Sie DeepSeek 4.1 auf Runable
DeepSeek 4.1 auswählen
Starten Sie eine Aufgabe auf Runable und wählen Sie DeepSeek 4.1 im Modellmenü aus.
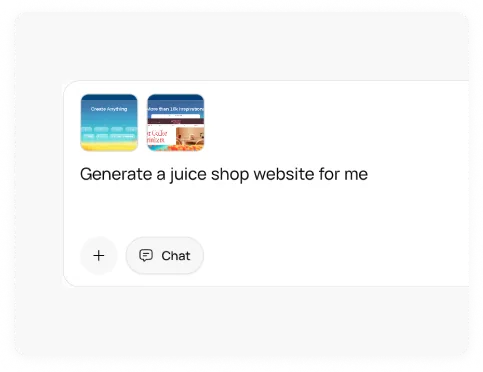
Beschreiben Sie den Auftrag
Geben Sie ein, was Sie benötigen, oder fügen Sie Dateien und Links hinzu. Runable plant alles und legt los.
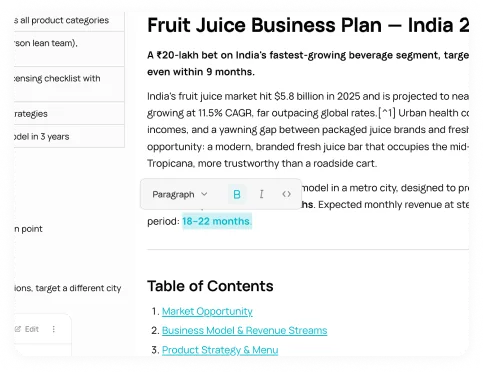
Bearbeiten und bereitstellen
Verfeinern Sie per Chat und veröffentlichen Sie die Seite oder exportieren Sie als PPTX, PDF oder Google Slides.
Ein Prompt, fertiges Ergebnis
Echte Ergebnisse aus Runable-Einzelaufgaben. Wählen Sie einen Clip zum Ansehen.
- Token-Kontextfenster
- 1M
- Maximale Ausgabe-Token
- 384K
- Token pro Sekunde (Artificial Analysis)
- 206
- Drehung zum Erstellen
- Ihr
Warum DeepSeek 4.1 wählen
Ein Bruchteil der Kosten
$0,30 / $1,20 pro 1 Mio. Token zu Spitzenzeiten, die Hälfte außerhalb der Stoßzeiten.
Übertrifft das eigene Flaggschiff
Laut DeepSeek besser als das DeepSeek V4-Pro.
Stark bei Agenten-Aufgaben
77,0 bei DeepSWE v1.1 und 60,5 bei AutomationBench.
Sehr lange Antworten
Bis zu 384K Ausgabe-Token pro Antwort.
Offene Gewichte
MIT-Lizenz, auf Hugging Face.
Klassenbester
Platz 2 von 121 in seiner Artificial Analysis-Kategorie.
DeepSeek 4.1-Spezifikationen
- Hersteller
- DeepSeek
- Modell
- DeepSeek-V4.1-Flash (aktualisiert als V4.1-Flash-1017 am 17. Okt. 2026)
- Veröffentlicht
- 10. September 2026
- API-Modell-ID
- deepseek-flash
- Kontextfenster
- 1 Mio. Token
- Maximaler Output
- 384.000 Token
- Eingabe / Ausgabe
- Text und Bilder als Eingabe, Text als Ausgabe
- Logisches Denken
- Denk- und Nicht-Denk-Modi; Aufwand niedrig, hoch oder maximal
- Architektur
- Mixture-of-Experts, offene Gewichte (MIT-Lizenz)
- API-Preis
- 0,30 $ Input / 1,20 $ Output pro 1 Mio. Token (Spitzenzeit); halb so viel außerhalb der Spitzenzeit
DeepSeek V4.1 im Vergleich zu anderen schnellen Modellen
Der Listenpreis von DeepSeek ist nur ein Bruchteil der anderen. Die Geschwindigkeiten stammen von Artificial Analysis, Oktober 2026; der Preis von DeepSeek entspricht dessen Spitzenzeiten-Tarif.
| Modell | Am besten geeignet für | Geschwindigkeit | API-Preis ein / aus |
|---|---|---|---|
| DeepSeek V4.1 | Kostengünstige Programmierung und Agentenarbeit | 206 Token/s | 0,30 $ / 1,20 $ |
| Haiku 5.5 | Schnelle Aufgaben mit hohem Volumen | 235 Token/s | 0,10 $ / 0,50 $ * |
| Sonnet 5.5 | Alltagsaufgaben, beste Geschwindigkeit für die Intelligenz | 134 Token/s | 2 $ / 10 $ |
| GPT-6.1 Sol | Ergebnisse nahe Astra zu niedrigeren Kosten | 55 Token/s | 2 $ / 10 $ |
Der einzige KI-Agent, den Sie brauchen
Benötigen Sie SSO, Datenlokalisierung, Premium-Support oder Onboarding-Hilfe? Vertrieb kontaktieren
Weitere KI-Modelle auf Runable



Setzen Sie DeepSeek 4.1 ein
Beschreiben Sie den Auftrag. Runable führt ihn mit DeepSeek 4.1 aus und liefert das Ergebnis.