Gemini 4 Neon-Preise: Was $3/$15 für Ihr Unternehmen bedeutet
Wichtige Erkenntnisse
- Gemini 4 Neon kostet 3 pro Million Ausgabe-Tokens bei einem Kontextfenster von 1 Million Tokens. Google positioniert es für komplexe Programmierung, analytisches Denken und produktionsreife Unternehmensabläufe, nicht als günstiges Modell für den Alltag. Die unten aufgeführten Preise gelten vom 21. November 2026, drei Tage nach der Einführung.
- Bei der Angabe von 3 handelt es sich um API-Preise, nicht um Preise für Workspace-Lizenzen. Dies ändert nichts direkt an Ihrem Workspace-Abonnement. Ob Sie Neon in den eigenen Produkten von Google verwenden können, hängt von Ihrem Plan, dem Produkt und den Einstellungen Ihres Administrators ab.
- Neon ist nicht im kostenlosen API-Tarif enthalten. Zwischengespeicherte Eingaben kosten 0,15 /7,50 $). Thinking-Tokens werden wie Ausgaben abgerechnet, sodass eine Aufgabe, die „nachdenkt“, mehr kostet, als die sichtbare Antwort vermuten lässt.
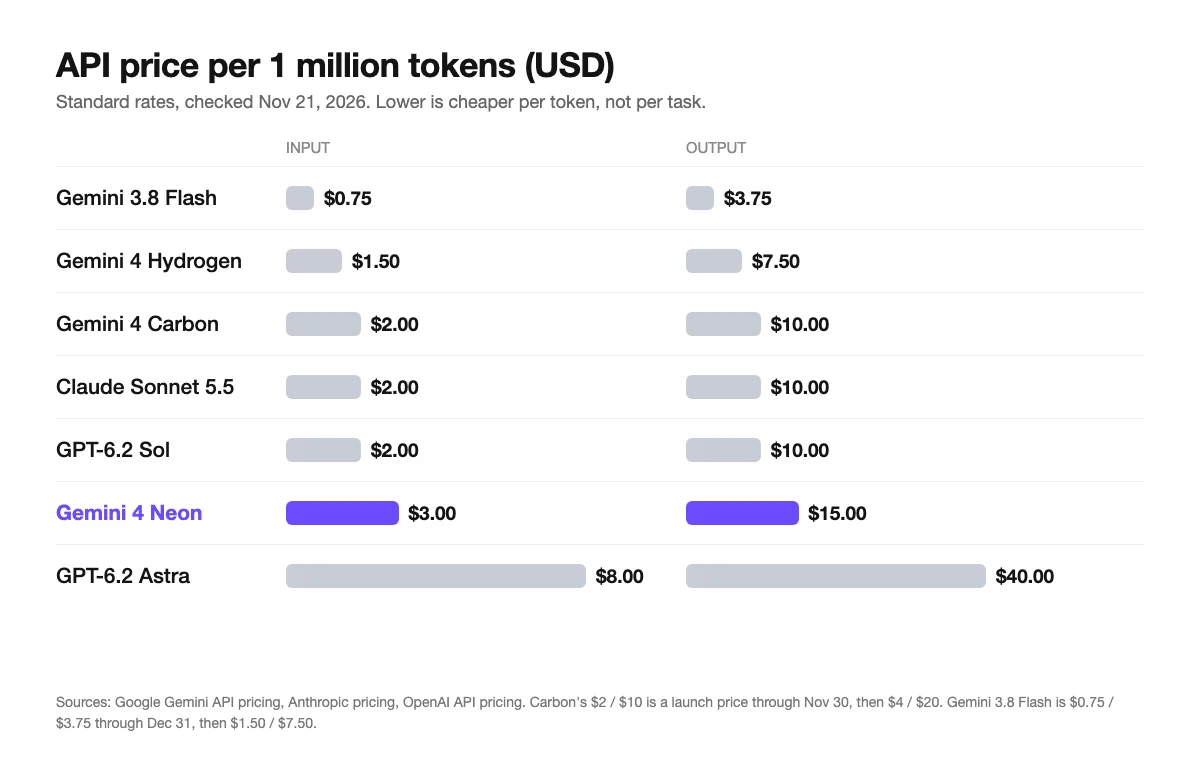
- Pro Token ist Neon teurer als Claude Sonnet 5.5 und OpenAI GPT-6.2 Sol (beide 2 ) und günstiger als GPT-6.2 Astra (8 ). Laut Google kostet Neon pro Aufgabe etwa 32 % weniger als Gemini 4 Carbon in der Standardeinstellung und 50 % bis 80 % weniger pro Aufgabe als einige konkurrierende Spitzenmodelle. Dies sind die Zahlen von Google, betrachten Sie sie also als eine Behauptung, die Sie bei Ihrer eigenen Arbeit testen sollten.
- Für die meisten Aufgaben kleiner Unternehmen ist unserer Meinung nach ein günstigeres Modell der bessere Ausgangspunkt. Verwenden Sie Neon dort, wo eine falsche Antwort teuer ist oder die Eingabe sehr lang ist.
- Unternehmen, die keine API-Schlüssel oder die Abrechnung pro Token verwalten möchten, können eine Agenten-Plattform wie Runable nutzen, die mit Plänen und Credits arbeitet. Runable ist unser Produkt, und wir haben Neon darin nicht getestet.
Gemini 4 Neon auf einen Blick: So ist die Preisgestaltung aufgebaut
| Modell | Eingabe $/M Tokens | Ausgabe $/M Tokens | Hinweise |
|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | 1M Kontext. Nur bezahlt. Zwischengespeicherte Eingabe 0,15 /7,50 $ |
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | Zwischengespeicherte Eingabe 0,075 $ |
| Gemini 4 Carbon | 2,00 $ | 10,00 $ | Einführungspreis bis 30. Nov. 2026, danach 4 |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Bis 31. Dez. 2026, danach 1,50 . Hat einen kostenlosen Tarif |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 1M Kontext |
| OpenAI GPT-6.2 Sol | 2,00 $ | 10,00 $ | Standardrate |
| OpenAI GPT-6.2 Astra | 8,00 $ | 40,00 $ | Standardrate |
Die Preise sind API-Raten pro Million Tokens, die am 21. November 2026 auf der Gemini API-Preisseite von Google, der Sonnet-Seite von Anthropic und der API-Preisseite von OpenAI überprüft wurden. Anbieter ändern diese häufig, prüfen Sie sie also, bevor Sie sich auf Mengen festlegen.
Was ist Gemini 4 Neon und was bedeutet $3/$15 eigentlich?
Gemini 4 Neon ist ein Modell aus der Gemini 4-Familie von Google, das am 18. November 2026 angekündigt wurde. Google beschreibt es als ein Modell, das Intelligenz auf Spitzen-Niveau in die Bereiche komplexe Softwareentwicklung, Wissensarbeit und Wissenschaft bringt. Der Launch-Beitrag richtet es auf Unternehmens-, Analyse- und wissenschaftliche Arbeit aus. Hydrogen, eine Stufe darunter, ist das Modell, das Google für alltägliche Programmierung und agentenbasierte Workflows empfiehlt.
Das Kürzel $3/$15 bezieht sich auf die beiden Raten pro Million Tokens. Eingabe-Tokens sind alles, was Sie an das Modell senden: Ihre Aufforderung, das Dokument, das Sie einfügen, die Tabellenkalkulation, die es liest. Ausgabe-Tokens sind alles, was es zurückschreibt. Ausgaben kosten mehr, weil die Generierung von Text mehr Rechenleistung erfordert als das Lesen.
Als Faustregel gilt: Ein Token entspricht etwa drei Vierteln eines englischen Wortes, also sind eine Million Tokens ungefähr 750.000 Wörter. Die meisten Aufgaben kleiner Unternehmen sind im Vergleich dazu winzig. Eine Kunden-E-Mail mit 400 Eingabe-Tokens und 250 Ausgabe-Tokens kostet etwa 0,005 $, was einem halben Cent entspricht.
Ein Detail ist wichtiger als der Listenpreis. Die Preisseite von Google besagt, dass die Ausgaberate von 15 $ Thinking-Tokens enthält und dass jedes Token, das das Modell verarbeitet, gezählt und in Rechnung gestellt wird, einschließlich Thinking-Tokens sowie interner Systemanweisungen und Funktionsdeklarationen bei der Verwendung von Grounding. Die Rechnung deckt also mehr ab als die sichtbare Antwort. Neon „denkt“ nach, bevor es antwortet, und Sie bezahlen für dieses Nachdenken, auch wenn Sie es nie sehen.
Wie schneidet Gemini 4 Neon im Vergleich zu Claude, GPT und anderen Gemini-Modellen ab?
Beim Listenpreis liegt Neon über den Mittelklasse-Modellen und unter dem teuersten. Es kostet sowohl bei der Eingabe als auch bei der Ausgabe 50 % mehr als Claude Sonnet 5.5 und GPT-6.2 Sol und etwa 60 % weniger als GPT-6.2 Astra.
Kontextfenster. Neon hat ein Kontextfenster von 1 Million Tokens. Das gilt auch für Claude Sonnet 5.5, sodass ein langer Kontext allein Neon nicht mehr auszeichnet. Es bedeutet jedoch, dass ein langer Vertrag oder ein voller Posteingang in einem Durchgang verarbeitet werden kann, was ein Stückeln vermeidet.
Kosten pro Aufgabe, nicht pro Token. Google gibt an, dass Neon bei seiner standardmäßigen hohen Thinking-Einstellung pro Aufgabe 32 % weniger kostet als Gemini 4 Carbon und etwa 50 % bis 80 % weniger pro Aufgabe als konkurrierende Spitzenmodelle. Das ist Googles eigene Behauptung aus dem Launch-Beitrag. Unabhängige Tests sind gemischter. Artificial Analysis bewertete Neon mit 61 auf seinem Intelligence Index bei xhigh thinking, bezeichnete es aber im Vergleich zu Modellen mit ähnlichem Preis als „etwas teuer“ und stellte fest, dass es langsam und wortreich sei. Der Kostenwert lag bei 6,44 $ pro Aufgabe auf ihrem eigenen Benchmark, was keine typische Aufgabe für kleine Unternehmen ist.
Wo es rangiert. Zum Start nannte Google Neon als Nummer 3 auf dem Artificial Analysis Intelligence Index bei xhigh. Sein Live-Ranking hat sich seitdem verschoben (die Seite von Artificial Analysis zeigte am 21. Nov. 2026 Platz 6 von 95), obwohl seine Punktzahl bei 61 bleibt. Google berichtete außerdem von Platz 2 auf dem Vals Index mit 70,9 %. Benchmarks messen Benchmark-Aufgaben, daher sagt ein Test mit Ihren eigenen Dokumenten mehr aus.
Das ehrliche Gegenargument ist, dass für kurze Prompts mit kurzen Antworten (Betreffzeilen, Chat-Antworten, Klassifizierungen) Gemini 3.8 Flash oder Hydrogen pro Aufgabe weniger kosten. Neon ist für schwierigere Arbeiten gebaut.
Was ändert sich für Gemini für Unternehmen und Workspace-Nutzer?
Der API-Preis ändert nichts direkt an Ihrem Workspace-Abonnement. Die Verfügbarkeit von Neon hängt von Ihrem Google-Plan, Produkt und den Administrator-Einstellungen ab.
Hier ist, was Google dazu gesagt hat, wo Neon verfügbar ist. Zum Start wurde es in der Gemini API und Google AI Studio eingeführt, in Gemini für Unternehmen (über die API und das Modell-Dropdown), für zahlende Google AI Pro- und Ultra-Abonnenten in Google Antigravity sowie für Pro- und Ultra-Abonnenten in der Gemini-App. Wenn Sie einen Business-Plan haben, erkundigen Sie sich bei Ihrem Administrator, bevor Sie davon ausgehen, dass Sie es haben.
Der Teil, den die meisten kleinen Unternehmen spüren werden, ist indirekt. Tools und Agenten, die auf Gemini aufbauen, zahlen diese Raten, daher beeinflusst die Wahl des Modells durch einen Anbieter deren Kosten. Ob das bei Ihnen als niedrigere Preise oder bessere Funktionen ankommt, hängt vom jeweiligen Anbieter ab.
Was man in den nächsten Monaten beobachten sollte (unsere Erwartungen, keine Fakten):
- Anbieter könnten stillschweigend upgraden. Tools, die ein günstigeres Modell zur Kostenkontrolle verwendeten, könnten auf Modelle der Neon-Klasse umsteigen, wenn sich die Kosten pro Aufgabe rechnen.
- Kostenlose Tarife könnten sich ändern. Günstigere Modelle können kostenlose Tarife großzügiger gestalten, aber Neon selbst hat derzeit keinen kostenlosen API-Tarif.
- Die KI-Preisgestaltung pro Lizenz könnte unter Druck geraten. Wenn die Rechenleistung hinter dem Monat eines typischen Nutzers ein paar Dollar beträgt, wird eine Pauschal- oder nutzungsbasierte Preisgestaltung leichter zu rechtfertigen. Wir würden nicht auf den Zeitpunkt wetten.
Was kostet $3/$15 ein kleines Unternehmen pro Monat?
Es hängt hauptsächlich davon ab, wie viel das Modell nachdenkt, daher ist die ehrliche Antwort eine Spanne. Die folgenden Zahlen sind illustrative Berechnungen basierend auf den veröffentlichten Preisen von Google. Sie sind keine Ergebnisse eines Tests, den wir durchgeführt haben.
Kosten pro Aufgabe unter Verwendung der Standard-Eingaberate von 3 für Neon:
- Kurze Kunden-E-Mail (400 Tokens Eingabe, 250 Ausgabe): etwa **0,005 )
- Mittlere Aufgabe (2.100 Eingabe, 680 Ausgabe, wie z.B. eine Produktbeschreibung aus einem Datenblatt): etwa **0,017 )
- Zusammenfassung eines langen Dokuments (52.000 Eingabe, 3.800 Ausgabe, etwa ein 40-seitiger Vertrag): etwa **0,21 )
Diese zählen nur den sichtbaren Text. Thinking-Tokens werden zum Ausgabetarif abgerechnet, und toolbezogene Tokens wie Funktionsdeklarationen und interne Tool-Anweisungen werden ebenfalls berechnet, daher fallen die tatsächlichen Rechnungen höher aus. Die Dokumente von Google legen die Rate nicht für jedes Tool-Token fest, überprüfen Sie also die Nutzungsmengen auf Ihrer eigenen Rechnung. Gehen wir als Gedankenexperiment von 2.000 versteckten Thinking-Tokens bei der mittleren Aufgabe aus. Das ist unsere Annahme, keine Messung. Die Aufgabe hat dann 2.680 Ausgabe-Tokens und kostet etwa 0,047 $.
Skalieren wir das nun auf einen Monat. Ein Einzelunternehmer, der 20 Aufgaben pro Tag an 22 Tagen erledigt, führt 440 Aufgaben durch:
- Nur sichtbare Tokens: etwa 7,26 $
- Mit den angenommenen 2.000 Thinking-Tokens pro Aufgabe: etwa 20,46 $
- Dasselbe Arbeitsvolumen bei Batch oder Flex (halber Preis, für Arbeit, die warten kann): etwa die Hälfte jeder Zahl
Die tatsächliche Nutzung wird abweichen, und anhaltende Arbeit mit langem Kontext, wie Tausende von Vertragsseiten oder ein Agent, der viele Male pro Auftrag schleift, kann weitaus mehr kosten. Zwischengespeicherte Eingaben zu 0,15 $ pro Million Tokens helfen, wenn Sie dasselbe lange Dokument wiederholt senden. Google merkt an, dass nur implizites Caching unterstützt wird. Der Weg, Ihre eigene Zahl zu erfahren, besteht darin, eine Woche lang echte Aufgaben auszuführen und die Token-Zahlen auf Ihrer Rechnung zu lesen.
Wann sollten Sie Neon gegenüber Hydrogen gegenüber Flash verwenden?
Dies ist unsere Meinung, keine Anleitung von Google. Verwenden Sie das günstigste Modell, das die Arbeit erledigt, und steigen Sie auf, wenn die Aufgabe schwierig ist oder ein Fehler kostspielig ist.
- Gemini 3.8 Flash (0,75 bis 31. Dez., danach 1,50 ): Hochvolumige, vorlagenbasierte Arbeit wie Tagging, kurze Antworten und Datenextraktion.
- Gemini 4 Hydrogen (1,50 ): alltägliche Programmierung und agentenbasierte Workflows, so positioniert es Google. Wir würden es auch zuerst für routinemäßiges Schreiben und Zusammenfassungen ausprobieren, aber das ist unsere Meinung, nicht die von Google.
- Gemini 4 Neon (3 ): komplexe Analyse, lange Arbeit mit mehreren Dokumenten, Programmierung und alles, wo eine schlampige Antwort Sie Geld oder Reputation kostet.
Testen Sie, bevor Sie sich festlegen. Führen Sie 10 Ihrer echten Aufgaben mit zwei Modellen aus, vergleichen Sie Qualität und Token-Anzahl und entscheiden Sie dann. Jede Aufgabe standardmäßig dem teuersten Modell zuzuweisen, „um sicherzugehen“, ist der übliche Weg, zu viel auszugeben.
Wie verwenden Sie Gemini 4 Neon, ohne Code zu schreiben?
Welchen Weg Sie erhalten, hängt von Ihrem Plan ab. Stand 21. November 2026 listet Google diese Orte auf, an denen Neon verfügbar ist:
- Die Gemini-App, für Pro- und Ultra-Abonnenten.
- Gemini für Unternehmen, über das Modell-Dropdown. Die Verfügbarkeit hängt von Ihrem Plan und den Einstellungen Ihres Administrators ab.
- Google AI Studio und die Gemini API, nur im bezahlten Tarif. Google sagt, dass Neon im kostenlosen Tarif nicht verfügbar ist.
- Google Antigravity, für zahlende AI Pro- und Ultra-Abonnenten.
Wo Runable passt
Wenn Sie keine API-Schlüssel, Modellauswahl oder Abrechnung pro Token verwalten möchten, ist eine Agenten-Plattform ein weiterer Weg. Runable ist unser Produkt: Sie beschreiben das fertige Ergebnis, das Sie benötigen, wie 15 Produktbeschreibungen, ein Wettbewerber-Briefing, eine Präsentation oder eine bereinigte Tabelle, und es plant den Workflow und liefert die fertige Arbeit zurück. Sie verwenden den Plan und die Credits von Runable, anstatt eine separate Gemini API-Rechnung zu erhalten.
Runable hat einen kostenlosen Tarif, wobei Pro ab November 2026 20 $ pro Monat kostet. Wir haben Neon in Runable nicht getestet, und dieser Artikel behauptet nicht, dass Runable es derzeit verwendet. Der Vergleich liegt zwischen der selbstständigen Verwaltung von Modell-APIs und der Nutzung einer ergebnisorientierten Agenten-Plattform.
Das praktische Fazit: Der Preis von 3 für Neon ist für gelegentliche, hochriskante Aufgaben leicht erschwinglich und es lohnt sich, ihn zu testen, bevor Sie ihn für das Volumen verwenden. Die verbleibende Frage ist der Workflow, nicht nur der Preis.
FAQ
Was bedeutet $3/$15 bei der Preisgestaltung von Gemini 4 Neon?
Es bedeutet 3 pro Million Ausgabe-Tokens (Text, den es generiert, einschließlich Thinking-Tokens). Eine Million Tokens sind ungefähr 750.000 Wörter, also kostet eine kurze geschäftliche Aufgabe wie eine E-Mail etwa einen halben Cent zu diesen Raten, vor jeglichen Thinking-Tokens.
Ist Gemini 4 Neon kostenlos zu verwenden?
Nicht über die API. Google sagt, dass Neon im kostenlosen Tarif der Gemini API nicht verfügbar ist und die API-Nutzung mit 3 pro Million Tokens berechnet wird. Zahlende Google AI Pro- und Ultra-Abonnenten können es in der Gemini-App und Antigravity verwenden, der Zugang hängt also von Ihrem Plan ab.
Ändert Gemini 4 Neon die Preise für Google Workspace?
Der API-Preis ändert nichts direkt an Ihrem Workspace-Abonnement. Die Verfügbarkeit von Neon hängt von Ihrem Google-Plan, Produkt und den Administrator-Einstellungen ab, erkundigen Sie sich also bei Ihrem Administrator.
Ist Gemini 4 Neon für kleine Unternehmen besser als GPT-6.2 oder Claude Sonnet 5.5?
Das hängt von der Arbeit ab. Pro Token kostet Neon (3 ) mehr als Claude Sonnet 5.5 und GPT-6.2 Sol (beide 2 ) und weniger als GPT-6.2 Astra (8 ). Google sagt, Neon sei pro Aufgabe günstiger als einige Spitzenmodelle, aber das ist die Behauptung von Google. Testen Sie zwei oder drei Modelle mit Ihren eigenen Aufgaben und vergleichen Sie die gesamten Token-Zahlen.
Wie viel günstiger sind Batch und zwischengespeicherte Eingaben?
Batch und Flex kosten die Hälfte des Standardpreises (1,50 Ausgabe pro Million Tokens). Zwischengespeicherte Eingaben kosten 0,15 $ pro Million Tokens, ein Rabatt von 95 % auf die Eingabe, nur mit implizitem Caching.
Weiterführende Literatur
- Google Gemini KI-Agent für Workspace: KMU-Leitfaden 2026
- KI-Tools für kleine Unternehmen: Die 10 besten im Jahr 2026 (getestet)
- Beste KI-Agenten für kleine Unternehmen im Jahr 2026 (nach Kategorie)
- KI-Automatisierung für kleine Unternehmen: Was man zuerst automatisieren sollte
- KI für Marketing in kleinen Unternehmen: 10 Wege zur Nutzung im Jahr 2026
- Die besten KI-Agenten im Jahr 2026: 12 Empfehlungen nach benötigter Aufgabe
Sparen Sie sich die Token-Rechnung: Beschreiben Sie die Aufgabe und lassen Sie Runable die Arbeit erledigen
Gemini 4 Neon wird nicht die letzte Preisänderung in diesem Jahr sein, und das Verfolgen von Preisen pro Token bei verschiedenen Anbietern ist für die meisten Unternehmen keine nützliche Arbeit. Runable verwandelt eine Anfrage in einfachem Englisch in ein fertiges Deck, ein Recherche-Briefing, eine Website, eine E-Mail-Kampagne oder eine bereinigte Tabelle. Starten Sie mit dem kostenlosen Tarif, geben Sie ihm eine echte Aufgabe aus Ihrer Woche und bewerten Sie das fertige Ergebnis, nicht die Token-Mathematik.

