Gemini 4 Neon 定价:3美元/15美元对您的业务意味着什么
关键要点
- Gemini 4 Neon 的价格为每百万输入 Token 3 美元,每百万输出 Token 15 美元,并具备 100 万 Token 的上下文窗口。Google 将其定位于复杂的编码、分析推理和生产级企业工作流程,而非便宜的日常模型。以下价格截至 2026 年 11 月 21 日(发布三天后)。
- 3 美元/15 美元的数字是 API 定价,而非 Workspace 席位价格。它不会直接改变您的 Workspace 订阅。您是否能在 Google 的自有产品中使用 Neon,取决于您的计划、产品和管理员设置。
- Neon 不在 API 免费层级内。缓存输入的价格为每百万 Token 0.15 美元,Batch 和 Flex 模式的价格减半(1.50 美元/7.50 美元)。思考 Token 按输出计费,因此一项“思考”任务的成本比看到的答案要高。
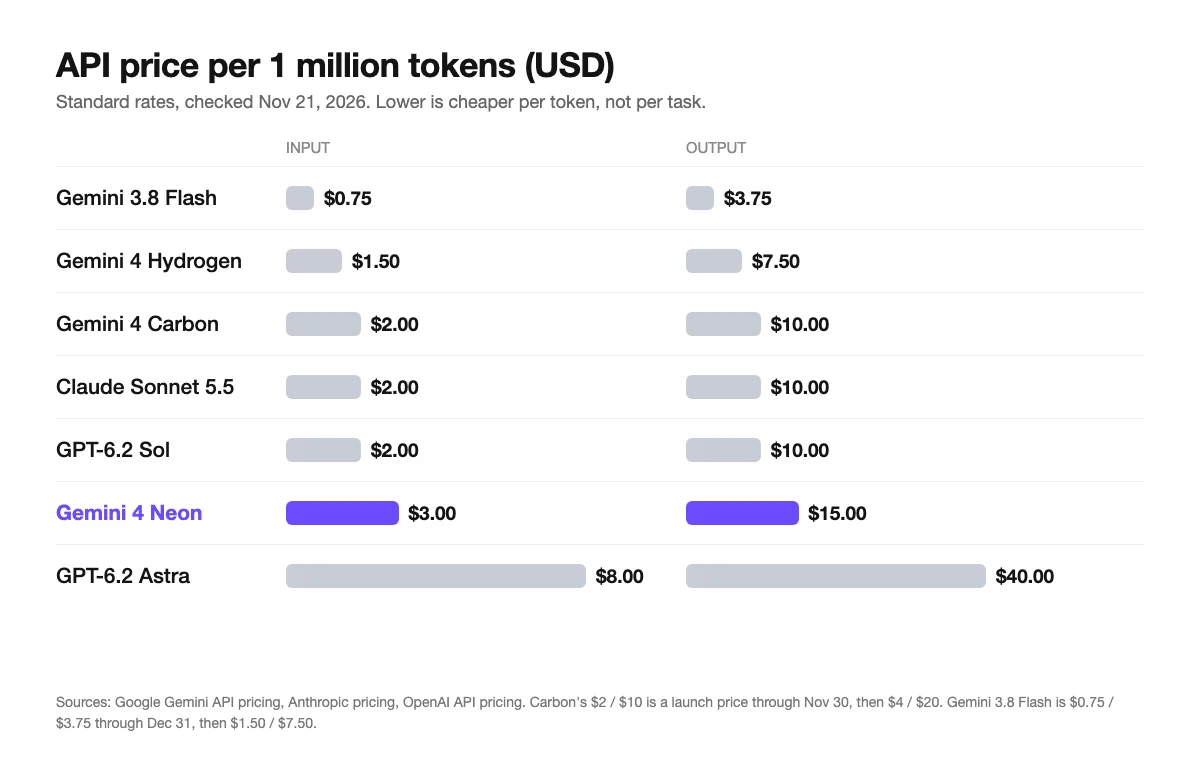
- 从每个 Token 的价格来看,Neon 比 Claude Sonnet 5.5 和 OpenAI 的 GPT-6.2 Sol(两者均为 2 美元/10 美元)更贵,但比 GPT-6.2 Astra(8 美元/40 美元)便宜。Google 表示,在默认设置下,完成同样任务时 Neon 比 Gemini 4 Carbon 的成本低约 32%,比某些竞争的前沿模型低 50% 到 80%。这些是 Google 的数据,因此请将其视为需要您在实际工作中检验的主张。
- 对于大多数小型企业任务,我们认为使用更便宜的模型是更好的起点。在错误答案代价高昂或输入非常长的情况下,请使用 Neon。
- 不想管理 API 密钥或按 Token 计费的企业,可以使用 Runable 之类的 Agent 平台,通过计划和积分来工作。Runable 是我们的产品,我们尚未在其中测试过 Neon。
Gemini 4 Neon 概览:定价对比
| 模型 | 输入 $/百万 Token | 输出 $/百万 Token | 备注 |
|---|---|---|---|
| Gemini 4 Neon | $3.00 | $15.00 | 100 万上下文。仅限付费。缓存输入 $0.15。Batch 和 Flex 为 $1.50/$7.50 |
| Gemini 4 Hydrogen | $1.50 | $7.50 | 缓存输入 $0.075 |
| Gemini 4 Carbon | $2.00 | $10.00 | 2026 年 11 月 30 日前为发布价格,之后为 $4/$20 |
| Gemini 3.8 Flash | $0.75 | $3.75 | 2026 年 12 月 31 日前,之后为 $1.50/$7.50。有免费层级 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 100 万上下文 |
| OpenAI GPT-6.2 Sol | $2.00 | $10.00 | 标准费率 |
| OpenAI GPT-6.2 Astra | $8.00 | $40.00 | 标准费率 |
以上价格为 2026 年 11 月 21 日查询到的每百万 Token API 标准费率,来源为 Google Gemini API 定价页面、Anthropic Sonnet 页面 和 OpenAI API 定价页面。提供商经常更改价格,因此请在大量投入前进行核实。
什么是 Gemini 4 Neon,3 美元/15 美元究竟意味着什么?
Gemini 4 Neon 是 Google Gemini 4 家族中的一个模型,于 2026 年 11 月 18 日发布。Google 描述其为将前沿水平的智能引入复杂的软件工程、知识工作和科学研究,其 发布文章 将其定位用于企业级、分析性和科学类工作。低一级的 Hydrogen 模型则是 Google 推荐用于日常编码和 Agent 工作流程的模型。
3 美元/15 美元的简写指的是每百万 Token 的两个费率。输入 Token 是您发送给模型的所有内容:您的提问、粘贴的文档、读取的电子表格。输出 Token 是它返回的所有内容。输出成本更高,因为生成文本比读取文本需要更多的计算资源。
通常情况下,一个 Token 大约相当于四分之三个英文单词,因此一百万 Token 大约是 75 万字。大多数小型企业任务与之相比非常小。一个输入 400 Token、输出 250 Token 的客户邮件,成本约为 0.005 美元,即半美分。
一个比标价更重要的细节是:Google 的 定价页面 显示,15 美元的输出费率包含了思考 Token,模型处理的每一个 Token 都会被计数和计费,包括思考 Token 以及使用落地检索(grounding)时的内部工具系统指令和函数声明。因此,账单涵盖的内容比您看到的答案要多。Neon 在回答之前会进行“思考”,即使您看不到这个过程,您也需要为这些思考支付费用。
Gemini 4 Neon 与 Claude、GPT 及其他 Gemini 模型相比如何?
从标价来看,Neon 位于中端模型之上,最昂贵的模型之下。其输入和输出成本均比 Claude Sonnet 5.5 和 GPT-6.2 Sol 高出 50%,比 GPT-6.2 Astra 低约 60%。
上下文窗口。 Neon 拥有 100 万 Token 的上下文窗口。Claude Sonnet 5.5 也是如此,因此长上下文本身已不再是 Neon 的独特优势。但这意味着长合同或完整的收件箱可以一次性输入,避免了分块处理。
按任务成本,而非按 Token。 Google 表示,在默认的高思考水平下,Neon 每项任务的成本比 Gemini 4 Carbon 低 32%,比顶级竞争前沿模型低约 50% 到 80%。这是 Google 在其发布文章中的主张。独立测试的结果则参差不齐。Artificial Analysis 在其高思考水平下的 Intelligence Index 中给 Neon 打分 61,但在类似价格的模型对比中称其“略显昂贵”,并指出其速度较慢且冗长。其基准测试显示每项任务的成本为 6.44 美元,这并非典型的小型企业任务。
排名位置。 发布时,Google 称 Neon 在 Artificial Analysis Intelligence Index 的高思考水平下排名第三。此后其实时排名有所变动(Artificial Analysis 页面 显示在 2026 年 11 月 21 日排名 95 个模型中的第 6 位),尽管其分数仍为 61。Google 还报告称其在 Vals Index 上以 70.9% 的得分排名第二。基准测试仅能衡量标准任务,因此针对您自身文档的测试才能告诉您更多信息。
诚恳的对照观点是,对于带有简短回答的简短提示(主题行、聊天回复、分类),Gemini 3.8 Flash 或 Hydrogen 每个任务的成本会更低。Neon 是为更艰巨的工作而构建的。
这对 Gemini for business 和 Workspace 用户有何变化?
API 价格不会直接改变您的 Workspace 订阅。Neon 的可用性取决于您的 Google 计划、产品和管理员设置。
以下是 Google 关于 Neon 可用性的说明。发布时,它在 Gemini API 和 Google AI Studio 中推出,在 Gemini for business(通过 API 和模型下拉菜单)中可用,面向 Google Antigravity 中的付费 Google AI Pro 和 Ultra 订阅者,以及 Gemini 应用中的 Pro 和 Ultra 订阅者。如果您使用的是企业计划,请在假设您已拥有该功能前先咨询您的管理员。
小型企业最能感受到的影响是间接的。构建在 Gemini 之上的工具和 Agent 需要支付这些费率,因此服务提供商对模型的选择会影响其成本。这是否会转化为更低的价格或更好的功能,取决于每个供应商。
未来几个月需要关注的内容(我们的预期,而非事实):
- 供应商可能会悄悄升级。 如果每项任务的成本可行,使用较便宜模型来控制成本的工具可能会转向 Neon 级别的模型。
- 免费层级可能会改变。 更便宜的模型可以使免费层级更慷慨,但 Neon 本身目前没有 API 免费层级。
- 基于席位的 AI 定价可能面临压力。 如果普通用户一个月的计算成本仅为几美元,那么固定或基于使用量的定价就更容易被证明合理。我们不会对时间节点进行预测。
3 美元/15 美元对小型企业每月意味着多少成本?
这主要取决于模型思考的程度,因此诚实的回答是一个范围。以下数字是根据 Google 公布价格进行的计算示例,并非我们进行的测试结果。
使用 Neon 标准的 3 美元输入和 15 美元输出费率,每项任务的成本计算如下:
- 简短客户邮件(400 个输入 Token,250 个输出):约 0.005 美元 (0.00495 美元)
- 中等任务(2,100 个输入,680 个输出,例如从规格表中生成产品描述):约 0.017 美元 (0.0165 美元)
- 长文档摘要(52,000 个输入,3,800 个输出,约 40 页合同):约 0.21 美元 (0.213 美元)
这些仅计算了可见文本。思考 Token 按输出费率计费,且与工具相关的 Token(如函数声明和内部工具指令)也会计费,因此实际账单会更高。Google 的文档并未详细说明每个工具 Token 的费率,因此请查看您自己账单上的使用统计。作为一种思维实验,假设中等任务有 2,000 个隐藏的思考 Token(这是我们的假设,而非测量值)。那么该任务就有 2,680 个输出 Token,成本约为 0.047 美元。
现在扩展到一个月。一位每天运行 20 个任务、持续 22 天的个体经营者共处理 440 个任务:
- 仅可见 Token: 约 7.26 美元
- 包含假设的每任务 2,000 个思考 Token: 约 20.46 美元
- 在 Batch 或 Flex 上的相同工作负载(半价,适用于可以等待的工作):上述任一数字的一半左右
实际使用情况会有所不同,持续的长上下文工作(例如数千页的合同,或在一个作业中循环多次的 Agent)成本可能会高得多。当您反复发送同一个长文档时,每百万 Token 0.15 美元的缓存输入会有所帮助。Google 指出,仅支持隐式缓存。了解您自身费用的方法是运行一周的实际任务,并查看账单上的 Token 计数。
何时应该使用 Neon、Hydrogen 还是 Flash?
这是我们的观点,而非 Google 的指导。使用能完成工作的最便宜模型,当任务困难或错误代价高昂时,再向上升级。
- Gemini 3.8 Flash(至 12 月 31 日为 0.75 美元/3.75 美元,之后为 1.50 美元/7.50 美元):高容量、模板化工作,如标记、简短回复和数据提取。
- Gemini 4 Hydrogen(1.50 美元/7.50 美元):日常编码和 Agent 工作流程,这是 Google 对其的定位。我们也会优先尝试将其用于常规写作和摘要,但这部分是我们的观点,而非 Google 的。
- Gemini 4 Neon(3 美元/15 美元):复杂的分析、长篇多文档工作、编码,以及任何错误答案会造成金钱或声誉损失的情况。
在投入使用前进行测试。在两个模型上运行 10 个您的真实任务,比较质量和 Token 数量,然后再做决定。为了“安全”而将所有任务默认设置为最昂贵的模型,是超支的常见原因。
如何在不编写任何代码的情况下使用 Gemini 4 Neon?
您获得的路径取决于您的计划。截至 2026 年 11 月 21 日,Google 列出了 Neon 可用的位置:
- Gemini 应用,面向 Pro 和 Ultra 订阅者。
- Gemini for business,通过模型下拉菜单。可用性取决于您的计划和管理员设置。
- Google AI Studio 和 Gemini API,仅限付费层级。Google 表示 Neon 在免费层级不可用。
- Google Antigravity,面向付费 AI Pro 和 Ultra 订阅者。
Runable 的适配位置
如果您不想管理 API 密钥、模型选择或按 Token 计费,Agent 平台是另一种途径。Runable 是我们的产品:您描述所需的最终结果,例如 15 个产品描述、竞品简介、演示文稿或清理过的电子表格,它会规划工作流程并返回完成的工作。您使用的是 Runable 的计划和积分,而不是接收单独的 Gemini API 账单。
Runable 有免费层级,截至 2026 年 11 月,Pro 计划为每月 20 美元。我们尚未在 Runable 中测试过 Neon,本文也不声称 Runable 目前正在使用它。这里的对比是关于您自己管理模型 API 与使用基于结果的 Agent 平台之间的差异。
实际的建议:Neon 3 美元/15 美元的价格对于偶尔的、高风险工作很容易负担,并且在将其用于大批量工作前值得测试。剩下的问题是工作流程,而不仅仅是价格。
常见问题
Gemini 4 Neon 定价中的 3 美元/15 美元是什么意思?
这意味着每百万输入 Token(您发送给模型的文本)3 美元,每百万输出 Token(它生成的文本,包括思考 Token)15 美元。一百万 Token 大约是 75 万字,因此按照这些费率,像电子邮件这样的小型业务任务成本约为半美分(在计算思考 Token 之前)。
Gemini 4 Neon 可以免费使用吗?
通过 API 不可以。Google 表示 Neon 在 Gemini API 免费层级中不可用,API 使用费率为每百万 Token 3 美元/15 美元。付费的 Google AI Pro 和 Ultra 订阅者可以在 Gemini 应用和 Antigravity 中使用它,因此访问权限取决于您的计划。
Gemini 4 Neon 会改变 Google Workspace 的定价吗?
API 价格不会直接改变您的 Workspace 订阅。Neon 的可用性取决于您的 Google 计划、产品和管理员设置,因此请咨询您的管理员。
对于小型企业来说,Gemini 4 Neon 比 GPT-6.2 或 Claude Sonnet 5.5 更好吗?
取决于具体工作。按 Token 计算,Neon(3 美元/15 美元)比 Claude Sonnet 5.5 和 GPT-6.2 Sol(两者均为 2 美元/10 美元)更贵,比 GPT-6.2 Astra(8 美元/40 美元)便宜。Google 表示 Neon 在完成同样任务时比某些前沿模型更便宜,但这只是 Google 的说法。在您自己的任务上测试两到三个模型,并比较总 Token 数量。
Batch 和缓存输入便宜多少?
Batch 和 Flex 是标准价格的一半(每百万 Token 输入 1.50 美元,输出 7.50 美元)。缓存输入的费用为每百万 Token 0.15 美元,即输入费用折扣 95%,且仅支持隐式缓存。
相关阅读
- Google Gemini AI Agent for Workspace: SMB Guide 2026
- AI Tools for Small Business: 10 Best in 2026 (Tested)
- Best AI Agents for Small Business in 2026 (By Category)
- AI Automation for Small Business: What to Automate First
- AI for Small Business Marketing: 10 Ways to Use It in 2026
- Best AI Agents in 2026: 12 Picks by the Job You Need Done
跳过 Token 数学:描述任务,让 Runable 完成工作
Gemini 4 Neon 不会是今年最后一次定价调整,对于大多数企业来说,跨提供商跟踪每 Token 价格并不是有用的工作。Runable 将普通的英文请求转化为完成的幻灯片、研究简报、网站、电子邮件活动或清理过的电子表格。从免费层级开始,用一周内的一个真实任务进行尝试,并评估完成的输出结果,而不是 Token 计算。

