Preços do Gemini 4 Neon: O que $3/$15 significam para o seu negócio
Principais conclusões
- O Gemini 4 Neon custa $3 por milhão de tokens de entrada e $15 por milhão de tokens de saída, com uma janela de contexto de 1 milhão de tokens. O Google posiciona o modelo para codificação complexa, raciocínio analítico e fluxos de trabalho empresariais de nível de produção, não como um modelo barato para o dia a dia. Os preços abaixo referem-se a 21 de novembro de 2026, três dias após o lançamento.
- O valor de $3/$15 é o preço da API, não o preço por licença do Workspace. Isso não altera diretamente a sua assinatura do Workspace. Se você pode ou não usar o Neon nos próprios produtos do Google depende do seu plano, do produto e das configurações do seu administrador.
- O Neon não está no nível gratuito da API. A entrada em cache custa $0,15 por milhão de tokens, e as modalidades Batch e Flex custam metade do preço ($1,50/$7,50). Os tokens de raciocínio são cobrados como saída, portanto, uma tarefa que "pensa" custa mais do que a resposta visível sugere.
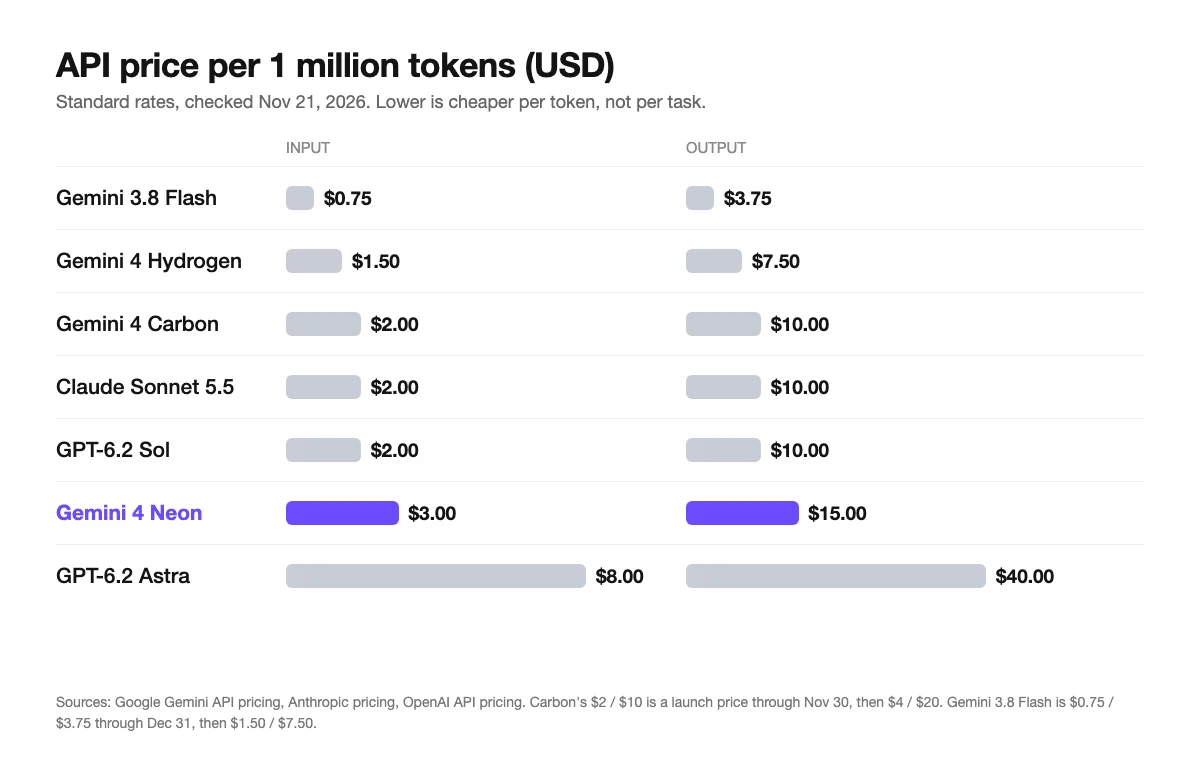
- Por token, o Neon é mais caro que o Claude Sonnet 5.5 e o GPT-6.2 Sol da OpenAI (ambos $2/$10) e mais barato que o GPT-6.2 Astra ($8/$40). O Google afirma que o Neon custa cerca de 32% menos por tarefa do que o Gemini 4 Carbon em sua configuração padrão, e de 50% a 80% menos por tarefa do que alguns modelos de fronteira concorrentes. Esses são números do Google, portanto, trate-os como uma afirmação a ser testada no seu próprio trabalho.
- Para a maioria das tarefas de pequenas empresas, nossa opinião é que um modelo mais barato é o melhor ponto de partida. Use o Neon onde uma resposta errada custa caro ou a entrada é muito longa.
- Empresas que não desejam gerenciar chaves de API ou cobrança por token podem usar uma plataforma de Agente como a Runable, que funciona por meio de planos e créditos. A Runable é o nosso produto e não testamos o Neon dentro dela.
Gemini 4 Neon em resumo: como ficam os preços
| Modelo | Entrada $/M tokens | Saída $/M tokens | Notas |
|---|---|---|---|
| Gemini 4 Neon | $3,00 | $15,00 | Contexto de 1M. Apenas pago. Entrada em cache $0,15. Batch e Flex $1,50/$7,50 |
| Gemini 4 Hydrogen | $1,50 | $7,50 | Entrada em cache $0,075 |
| Gemini 4 Carbon | $2,00 | $10,00 | Preço de lançamento até 30 de nov de 2026, depois $4/$20 |
| Gemini 3.8 Flash | $0,75 | $3,75 | Até 31 de dez de 2026, depois $1,50/$7,50. Possui nível gratuito |
| Claude Sonnet 5.5 | $2,00 | $10,00 | Contexto de 1M |
| OpenAI GPT-6.2 Sol | $2,00 | $10,00 | Taxa padrão |
| OpenAI GPT-6.2 Astra | $8,00 | $40,00 | Taxa padrão |
Os preços são taxas de API por milhão de tokens publicadas em 21 de novembro de 2026, a partir da página de preços da API Gemini do Google, da página do Sonnet da Anthropic e da página de preços da API da OpenAI. Os provedores mudam esses valores com frequência, portanto, verifique-os antes de se comprometer com grandes volumes.
O que é o Gemini 4 Neon e o que significam realmente os $3/$15?
O Gemini 4 Neon é um modelo da família Gemini 4 do Google, anunciado em 18 de novembro de 2026. O Google descreve-o como trazendo inteligência de nível de fronteira para engenharia de software complexa, trabalho intelectual e ciência, e seu post de lançamento o direciona para trabalhos empresariais, analíticos e científicos. O Hydrogen, um nível abaixo, é o modelo que o Google recomenda para codificação cotidiana e fluxos de trabalho de agentes.
A abreviação $3/$15 refere-se às duas taxas por milhão de tokens. Os tokens de entrada são tudo o que você envia ao modelo: seu prompt, o documento que você cola, a planilha que ele lê. Os tokens de saída são tudo o que ele escreve de volta. A saída custa mais porque gerar texto exige mais processamento do que lê-lo.
Como regra geral, um token equivale a cerca de três quartos de uma palavra em inglês, então um milhão de tokens corresponde a aproximadamente 750.000 palavras. A maioria das tarefas de pequenas empresas é minúscula em comparação a isso. Um e-mail de cliente com 400 tokens de entrada e 250 tokens de saída custa cerca de $0,005, ou seja, meio centavo.
Um detalhe importa mais do que o preço de etiqueta. A página de preços do Google diz que a taxa de saída de $15 inclui tokens de raciocínio, e que cada token que o modelo processa é contado e cobrado, incluindo tokens de raciocínio e instruções internas de sistema de ferramentas e declarações de função ao usar aterramento (grounding). Portanto, a conta cobre mais do que a resposta visível. O Neon "pensa" antes de responder, e você paga por esse raciocínio, embora nunca o veja.
Como o Gemini 4 Neon se compara ao Claude, ao GPT e a outros modelos Gemini?
Em preço de etiqueta, o Neon situa-se acima dos modelos de nível intermediário e abaixo do mais caro. Ele custa 50% a mais que o Claude Sonnet 5.5 e o GPT-6.2 Sol tanto na entrada quanto na saída, e cerca de 60% a menos que o GPT-6.2 Astra.
Janela de contexto. O Neon tem uma janela de contexto de 1 milhão de tokens. O Claude Sonnet 5.5 também, então um contexto longo por si só já não diferencia o Neon. Isso significa que um contrato longo ou uma caixa de entrada cheia podem ser processados de uma só vez, o que evita a fragmentação.
Custo por tarefa, não por token. O Google afirma que, em seu nível padrão de raciocínio alto, o Neon custa 32% menos por tarefa do que o Gemini 4 Carbon e, aproximadamente, de 50% a 80% menos por tarefa do que os principais modelos de fronteira concorrentes. Essa é uma alegação do próprio Google em seu post de lançamento. Testes independentes são mais variados. O Artificial Analysis atribuiu ao Neon 61 em seu Índice de Inteligência com raciocínio xhigh, mas classificou-o como "um pouco caro" em comparação com modelos de preço semelhante e observou que ele é lento e prolixo. Seu número de custo foi de $6,44 por tarefa em seu próprio benchmark, que não é uma tarefa típica de pequenas empresas.
Onde ele se classifica. No lançamento, o Google citou o Neon como o nº 3 no Índice de Inteligência da Artificial Analysis em xhigh. Sua classificação ao vivo mudou desde então (a página da Artificial Analysis mostrava o nº 6 de 95 em 21 de novembro de 2026), embora sua pontuação permaneça 61. O Google também relatou o nº 2 no Índice Vals com 70,9%. Benchmarks medem tarefas de referência, portanto, um teste com seus próprios documentos lhe dirá mais.
O contraponto honesto é que, para prompts curtos com respostas curtas (linhas de assunto, respostas de chat, classificação), o Gemini 3.8 Flash ou o Hydrogen custarão menos por tarefa. O Neon foi criado para trabalhos mais difíceis.
O que muda para os usuários do Gemini para empresas e Workspace?
O preço da API não altera diretamente sua assinatura do Workspace. A disponibilidade do Neon depende do seu plano do Google, produto e configurações de administrador.
Aqui está o que o Google disse sobre onde o Neon está disponível. No lançamento, ele foi disponibilizado na API do Gemini e no Google AI Studio, no Gemini para empresas (por meio da API e do menu suspenso de modelos), para assinantes pagos do Google AI Pro e Ultra no Google Antigravity e para assinantes Pro e Ultra no aplicativo Gemini. Se você estiver em um plano empresarial, verifique com seu administrador antes de presumir que você o possui.
A parte que a maioria das pequenas empresas sentirá é indireta. Ferramentas e agentes criados com base no Gemini pagam essas taxas, portanto, a escolha de modelo de um fornecedor afeta seus custos. Se isso chegar até você como preços mais baixos ou melhores recursos depende de cada fornecedor.
O que observar nos próximos meses (nossas expectativas, não fatos):
- Fornecedores podem atualizar discretamente. Ferramentas que usavam um modelo mais barato para controlar custos podem passar a usar modelos da classe Neon se o custo por tarefa for viável.
- Níveis gratuitos podem mudar. Modelos mais baratos podem tornar os níveis gratuitos mais generosos, mas o próprio Neon não tem nível gratuito de API hoje.
- Preços de IA por licença podem sofrer pressão. Se o processamento por trás do mês de um usuário típico custa alguns dólares, preços fixos ou baseados em uso tornam-se mais fáceis de justificar. Não apostaríamos no cronograma.
Quanto custam os $3/$15 para uma pequena empresa por mês?
Depende principalmente de quanto o modelo pensa, então a resposta honesta é uma estimativa. Os números abaixo são cálculos ilustrativos dos preços publicados pelo Google. Eles não são resultados de um teste que realizamos.
Custos por tarefa, usando as taxas padrão de $3 de entrada e $15 de saída do Neon:
- E-mail curto para cliente (400 tokens de entrada, 250 de saída): cerca de $0,005 ($0,00495)
- Tarefa média (2.100 de entrada, 680 de saída, como uma descrição de produto de uma folha de especificações): cerca de $0,017 ($0,0165)
- Resumo de documento longo (52.000 de entrada, 3.800 de saída, aproximadamente um contrato de 40 páginas): cerca de $0,21 ($0.213)
Esses valores contam apenas o texto visível. Tokens de raciocínio são cobrados na taxa de saída, e tokens relacionados a ferramentas, como declarações de função e instruções internas de ferramentas, também são cobrados, portanto, as faturas reais são mais altas. A documentação do Google não especifica a taxa para cada token de ferramenta, então verifique as contagens de uso em sua própria fatura. Como um exercício mental, suponha 2.000 tokens de raciocínio ocultos na tarefa média. Essa é a nossa suposição, não uma medição. A tarefa então tem 2.680 tokens de saída e custa cerca de $0,047.
Agora escale para um mês. Um operador solo realizando 20 tarefas por dia durante 22 dias faz 440 tarefas:
- Apenas tokens visíveis: cerca de $7,26
- Com os 2.000 tokens de raciocínio assumidos por tarefa: cerca de $20,46
- A mesma carga de trabalho em Batch ou Flex (metade do preço, para trabalhos que podem esperar): cerca de metade de qualquer um dos números
O uso real será diferente, e trabalhos de contexto longo sustentados, como milhares de páginas de contratos ou um agente que realiza muitos loops por trabalho, podem custar muito mais. A entrada em cache a $0,15 por milhão de tokens ajuda quando você envia o mesmo documento longo repetidamente. O Google observa que apenas o cache implícito é suportado. A maneira de saber o seu número é realizar uma semana de tarefas reais e ler as contagens de tokens na sua fatura.
Quando você deve usar Neon versus Hydrogen versus Flash?
Esta é a nossa opinião, não a orientação do Google. Use o modelo mais barato que faça o trabalho e mude para um modelo superior quando a tarefa for difícil ou um erro custar caro.
- Gemini 3.8 Flash ($0,75/$3,75 até 31 de dez, depois $1,50/$7,50): trabalho de alto volume e padronizado, como marcação, respostas curtas e extração de dados.
- Gemini 4 Hydrogen ($1,50/$7,50): codificação diária e fluxos de trabalho de agentes, que é como o Google o posiciona. Também tentaríamos primeiro para escrita e resumos de rotina, mas essa parte é nossa opinião, não a do Google.
- Gemini 4 Neon ($3/$15): análise complexa, trabalho longo com vários documentos, codificação e qualquer coisa em que uma resposta desleixada custe dinheiro ou reputação.
Teste antes de se comprometer. Execute 10 das suas tarefas reais em dois modelos, compare a qualidade e as contagens de tokens e, em seguida, decida. Definir automaticamente todas as tarefas para o modelo mais caro "por segurança" é a maneira comum de gastar demais.
Como usar o Gemini 4 Neon sem escrever código?
O caminho que você terá depende do seu plano. Em 21 de novembro de 2026, o Google lista estes locais onde o Neon está disponível:
- O aplicativo Gemini, para assinantes Pro e Ultra.
- Gemini para empresas, por meio do menu suspenso de modelos. A disponibilidade depende do seu plano e das configurações do seu administrador.
- Google AI Studio e a API Gemini, apenas no nível pago. O Google diz que o Neon não está disponível no nível gratuito.
- Google Antigravity, para assinantes pagos do AI Pro e Ultra.
Onde a Runable se encaixa
Se você não quer gerenciar chaves de API, seleção de modelo ou cobrança por token, uma plataforma de agente é outro caminho. Runable é o nosso produto: você descreve o resultado final que precisa, como 15 descrições de produtos, um resumo de concorrente, uma apresentação ou uma planilha organizada, e ele planeja o fluxo de trabalho e retorna o trabalho concluído. Você usa o plano e os créditos da Runable em vez de receber uma fatura separada da API Gemini.
A Runable tem um nível gratuito, com o Pro a $20 por mês em novembro de 2026. Não testamos o Neon dentro da Runable, e este artigo não afirma que a Runable o utiliza atualmente. A comparação é entre gerenciar APIs de modelo você mesmo e usar uma plataforma de agente baseada em resultados.
A conclusão prática: o preço de $3/$15 do Neon é fácil de pagar para trabalhos ocasionais e de alto risco, e vale a pena testar antes de usar em volume. A questão restante é o fluxo de trabalho, não apenas o preço.
Perguntas frequentes
O que significam os $3/$15 nos preços do Gemini 4 Neon?
Significa $3 por milhão de tokens de entrada (texto que você envia ao modelo) e $15 por milhão de tokens de saída (texto que ele gera, incluindo tokens de raciocínio). Um milhão de tokens equivale a cerca de 750.000 palavras, portanto, uma tarefa empresarial curta, como um e-mail, custa cerca de meio centavo nessas taxas, antes de quaisquer tokens de raciocínio.
O Gemini 4 Neon é gratuito?
Não por meio da API. O Google diz que o Neon não está disponível no nível gratuito da API Gemini, e o uso da API é cobrado a $3/$15 por milhão de tokens. Assinantes pagos do Google AI Pro e Ultra podem usá-lo no aplicativo Gemini e no Antigravity, portanto, o acesso depende do seu plano.
O Gemini 4 Neon altera os preços do Google Workspace?
O preço da API não altera diretamente sua assinatura do Workspace. A disponibilidade do Neon depende do seu plano do Google, produto e configurações de administrador, portanto, verifique com seu administrador.
O Gemini 4 Neon é melhor que o GPT-6.2 ou o Claude Sonnet 5.5 para pequenas empresas?
Depende do trabalho. Por token, o Neon ($3/$15) custa mais do que o Claude Sonnet 5.5 e o GPT-6.2 Sol (ambos $2/$10) e menos que o GPT-6.2 Astra ($8/$40). O Google diz que o Neon é mais barato por tarefa do que alguns modelos de fronteira, mas essa é uma alegação do Google. Teste dois ou três modelos em suas próprias tarefas e compare as contagens totais de tokens.
Quanto mais baratos são o Batch e a entrada em cache?
Batch e Flex custam metade do preço padrão ($1,50 de entrada, $7,50 de saída por milhão de tokens). A entrada em cache custa $0,15 por milhão de tokens, um desconto de 95% na entrada, apenas com cache implícito.
Leitura relacionada
- Agente de IA Google Gemini para Workspace: Guia para PMEs 2026
- Ferramentas de IA para Pequenas Empresas: As 10 melhores em 2026 (Testadas)
- Melhores Agentes de IA para Pequenas Empresas em 2026 (Por categoria)
- Automação de IA para Pequenas Empresas: O que automatizar primeiro
- IA para Marketing de Pequenas Empresas: 10 maneiras de usar em 2026
- Melhores Agentes de IA em 2026: 12 escolhas pelo trabalho que você precisa realizar
Esqueça os cálculos de tokens: descreva a tarefa e deixe a Runable fazer o trabalho
O Gemini 4 Neon não será a última mudança de preço deste ano, e acompanhar os preços por token entre os provedores não é um trabalho útil para a maioria das empresas. A Runable transforma um pedido em inglês simples em um deck finalizado, resumo de pesquisa, site, campanha de e-mail ou planilha organizada. Comece no nível gratuito, dê a ela uma tarefa real da sua semana e avalie o resultado concluído, não o cálculo de tokens.

