Prezzi di Gemini 4 Neon: cosa significano 3 $/15 $ per la tua attività
Punti chiave
- Gemini 4 Neon costa 3 per milione di token di output, con una finestra di contesto di 1 milione di token. Google lo posiziona per codifica complessa, ragionamento analitico e flussi di lavoro aziendali di produzione, non come un modello economico per tutti i giorni. I prezzi indicati sono aggiornati al 21 novembre 2026, tre giorni dopo il lancio.
- La cifra di 3 è il prezzo dell'API, non il prezzo di una licenza Workspace. Non modifica direttamente il tuo abbonamento Workspace. La possibilità di utilizzare Neon nei prodotti Google dipende dal tuo piano, dal prodotto e dalle impostazioni dell'amministratore.
- Neon non è nel livello gratuito dell'API. L'input memorizzato nella cache costa 0,15 /7,50 $). I token di riflessione vengono conteggiati come output, quindi un'attività che "riflette" costa più di quanto suggerisca la risposta visibile.
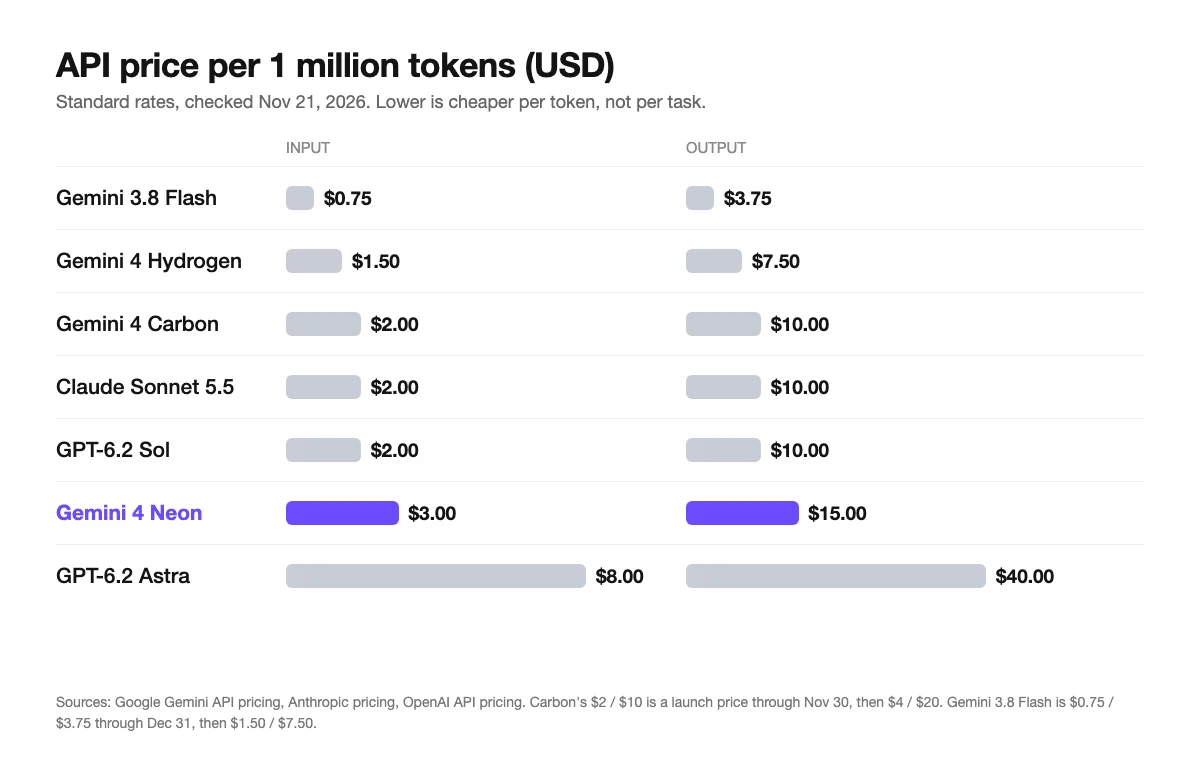
- Per token, Neon è più costoso di Claude Sonnet 5.5 e GPT-6.2 Sol di OpenAI (entrambi 2 ) e più economico di GPT-6.2 Astra (8 ). Google afferma che Neon costa circa il 32% in meno per attività rispetto a Gemini 4 Carbon con le impostazioni predefinite e dal 50% all'80% in meno per attività rispetto ad alcuni modelli di frontiera concorrenti. Queste sono le cifre di Google, quindi trattale come un'affermazione da testare con il tuo lavoro.
- Per la maggior parte delle attività delle piccole imprese, la nostra opinione è che un modello più economico sia un punto di partenza migliore. Usa Neon quando una risposta errata è costosa o l'input è molto lungo.
- Le aziende che non vogliono gestire chiavi API o fatturazione per token possono utilizzare una piattaforma di agenti come Runable, che funziona tramite piani e crediti. Runable è il nostro prodotto e non abbiamo testato Neon al suo interno.
Gemini 4 Neon in breve: come si posizionano i prezzi
| Modello | Input $/M token | Output $/M token | Note |
|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | Contesto 1M. Solo a pagamento. Input cache 0,15 /7,50 $ |
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | Input cache 0,075 $ |
| Gemini 4 Carbon | 2,00 $ | 10,00 $ | Prezzo di lancio fino al 30 nov 2026, poi 4 |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Fino al 31 dic 2026, poi 1,50 . Ha un livello gratuito |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | Contesto 1M |
| OpenAI GPT-6.2 Sol | 2,00 $ | 10,00 $ | Tariffa standard |
| OpenAI GPT-6.2 Astra | 8,00 $ | 40,00 $ | Tariffa standard |
I prezzi sono tariffe API per milione di token pubblicate e verificate il 21 novembre 2026, tratte dalla pagina dei prezzi dell'API Gemini di Google, dalla pagina di Sonnet di Anthropic e dalla pagina dei prezzi dell'API di OpenAI. I fornitori li modificano spesso, quindi controllali prima di impegnarti su grandi volumi.
Cos'è Gemini 4 Neon e cosa significano realmente 3 ?
Gemini 4 Neon è un modello della famiglia Gemini 4 di Google, annunciato il 18 novembre 2026. Google lo descrive come uno strumento che porta l'intelligenza di frontiera nell'ingegneria del software complessa, nel lavoro di conoscenza e nella scienza, e il suo post di lancio lo propone per il lavoro aziendale, analitico e scientifico. Hydrogen, un gradino sotto, è il modello che Google propone per la codifica quotidiana e i flussi di lavoro agentici.
La sigla 3 si riferisce alle due tariffe per milione di token. I token di input sono tutto ciò che invii al modello: il tuo prompt, il documento che incolli, il foglio di calcolo che legge. I token di output sono tutto ciò che scrive in risposta. L'output costa di più perché generare testo richiede più calcolo rispetto alla lettura.
Come regola generale, un token equivale a circa tre quarti di una parola inglese, quindi un milione di token equivale a circa 750.000 parole. La maggior parte delle attività delle piccole imprese è minuscola in confronto. Un'email a un cliente con 400 token in ingresso e 250 in uscita costa circa 0,005 $, ovvero mezzo centesimo.
Un dettaglio conta più del prezzo di listino. La pagina dei prezzi di Google afferma che la tariffa di output di 15 $ include i token di riflessione e che ogni token elaborato dal modello viene conteggiato e fatturato, inclusi i token di riflessione e le istruzioni di sistema degli strumenti interni e le dichiarazioni di funzione quando si utilizza il grounding. Quindi la fattura copre più della risposta visibile. Neon "riflette" prima di rispondere e tu paghi per quella riflessione anche se non la vedi mai.
Come si confronta Gemini 4 Neon con Claude, GPT e gli altri modelli Gemini?
Per quanto riguarda il prezzo di listino, Neon si colloca sopra i modelli di fascia media e sotto quello più costoso. Costa il 50% in più rispetto a Claude Sonnet 5.5 e GPT-6.2 Sol sia in input che in output, e circa il 60% in meno rispetto a GPT-6.2 Astra.
Finestra di contesto. Neon ha una finestra di contesto di 1 milione di token. Anche Claude Sonnet 5.5, quindi un lungo contesto da solo non distingue più Neon. Significa però che un contratto lungo o una casella di posta completa possono essere inseriti in un'unica soluzione, evitando di dover suddividere i dati.
Costo per attività, non per token. Google afferma che al suo livello di riflessione predefinito (alto), Neon costa il 32% in meno per attività rispetto a Gemini 4 Carbon e tra il 50% e l'80% in meno per attività rispetto ai migliori modelli di frontiera concorrenti. Questa è un'affermazione di Google tratta dal suo post di lancio. I test indipendenti sono più contrastanti. Artificial Analysis ha assegnato a Neon un punteggio di 61 sul suo Intelligence Index con riflessione "molto alta", ma lo ha definito "piuttosto costoso" rispetto a modelli di prezzo simile e ha notato che è lento e prolisso. La sua cifra di costo era di 6,44 $ per attività nel suo benchmark, che non è un'attività tipica delle piccole imprese.
Dove si posiziona. Al lancio, Google ha citato Neon al 3° posto nell'Artificial Analysis Intelligence Index con riflessione "molto alta". Il suo posizionamento in tempo reale è cambiato da allora (la pagina di Artificial Analysis mostrava il 6° posto su 95 il 21 novembre 2026), sebbene il suo punteggio rimanga 61. Google ha anche riportato un 2° posto sul Vals Index al 70,9%. I benchmark misurano attività standard, quindi un test sui tuoi documenti ti dirà di più.
Il controargomento onesto è che per prompt brevi con risposte brevi (oggetti, risposte in chat, classificazione), Gemini 3.8 Flash o Hydrogen costeranno meno per attività. Neon è costruito per il lavoro più duro.
Cosa cambia per gli utenti di Gemini for business e Workspace?
Il prezzo dell'API non modifica direttamente il tuo abbonamento Workspace. La disponibilità di Neon dipende dal tuo piano Google, dal prodotto e dalle impostazioni dell'amministratore.
Ecco cosa ha detto Google sulla disponibilità di Neon. Al lancio, è stato distribuito nell'API Gemini e in Google AI Studio, in Gemini for business (tramite l'API e il menu a tendina dei modelli), per gli abbonati paganti a Google AI Pro e Ultra in Google Antigravity e per gli abbonati Pro e Ultra nell'app Gemini. Se hai un piano aziendale, verifica con il tuo amministratore prima di dare per scontato di averlo.
La parte che la maggior parte delle piccole imprese avvertirà è indiretta. Gli strumenti e gli agenti basati su Gemini pagano queste tariffe, quindi la scelta del modello da parte di un fornitore influisce sui suoi costi. Se questo si tradurrà per te in prezzi più bassi o funzionalità migliori dipende da ogni singolo fornitore.
Cosa osservare nei prossimi mesi (le nostre aspettative, non fatti):
- I fornitori potrebbero aggiornare silenziosamente. Gli strumenti che utilizzavano un modello più economico per controllare i costi potrebbero passare a modelli di classe Neon se il costo per attività risulta conveniente.
- I livelli gratuiti potrebbero cambiare. I modelli più economici possono rendere i livelli gratuiti più generosi, ma Neon di per sé non ha un livello API gratuito oggi.
- Il prezzo dell'IA per utente potrebbe subire pressioni. Se il costo di calcolo dietro il mese di un utente tipico è di pochi dollari, diventa più facile giustificare prezzi fissi o basati sull'utilizzo. Non scommetteremmo sulle tempistiche.
Quanto costa 3 a una piccola impresa al mese?
Dipende principalmente da quanto "riflette" il modello, quindi la risposta onesta è un intervallo. Le cifre seguenti sono calcoli illustrativi basati sui prezzi pubblicati da Google. Non sono risultati di un test che abbiamo eseguito.
Costi per attività, utilizzando le tariffe standard di Neon di 3 in output:
- Breve email al cliente (400 token in ingresso, 250 in uscita): circa **0,005 )
- Attività media (2.100 in ingresso, 680 in uscita, come una descrizione prodotto da una scheda tecnica): circa **0,017 )
- Riassunto documento lungo (52.000 in ingresso, 3.800 in uscita, circa un contratto di 40 pagine): circa **0,21 )
Questi conteggiano solo il testo visibile. I token di riflessione vengono fatturati alla tariffa di output e vengono conteggiati anche i token relativi agli strumenti, come le dichiarazioni di funzione e le istruzioni degli strumenti interni, quindi le bollette reali sono più alte. I documenti di Google non specificano la tariffa per ogni token di strumento, quindi controlla i conteggi di utilizzo sulla tua fattura. Come esperimento mentale, assumiamo 2.000 token di riflessione nascosti per l'attività media. Questa è la nostra ipotesi, non una misurazione. L'attività ha quindi 2.680 token di output e costa circa 0,047 $.
Ora estendiamo il calcolo a un mese. Un operatore singolo che esegue 20 attività al giorno per 22 giorni svolge 440 attività:
- Solo token visibili: circa 7,26 $
- Con i 2.000 token di riflessione ipotizzati per attività: circa 20,46 $
- Lo stesso carico di lavoro su Batch o Flex (metà prezzo, per il lavoro che può attendere): circa la metà di una delle due cifre
L'utilizzo reale differirà e il lavoro a lungo contesto sostenuto, come migliaia di pagine di contratti o un agente che esegue molti cicli per lavoro, può costare molto di più. L'input memorizzato nella cache a 0,15 $ per milione di token aiuta quando si invia ripetutamente lo stesso documento lungo. Google osserva che è supportata solo la memorizzazione nella cache implicita. Il modo per conoscere il tuo numero è eseguire una settimana di attività reali e leggere i conteggi dei token sulla tua fattura.
Quando dovresti usare Neon rispetto a Hydrogen rispetto a Flash?
Questa è la nostra opinione, non una guida di Google. Usa il modello più economico che fa il suo dovere e passa a quello superiore quando l'attività è difficile o un errore è costoso.
- Gemini 3.8 Flash (0,75 fino al 31 dic, poi 1,50 ): lavoro ad alto volume, basato su modelli come tagging, brevi risposte ed estrazione dati.
- Gemini 4 Hydrogen (1,50 ): codifica quotidiana e flussi di lavoro agentici, che è come Google lo posiziona. Proveremmo anche questo per primi per la scrittura di routine e i riassunti, ma questa parte è la nostra opinione, non quella di Google.
- Gemini 4 Neon (3 ): analisi complessa, lavoro lungo su più documenti, codifica e qualsiasi cosa in cui una risposta approssimativa ti costi denaro o reputazione.
Testa prima di impegnarti. Esegui 10 delle tue attività reali su due modelli, confronta la qualità e il conteggio dei token, quindi decidi. Impostare di default ogni attività sul modello più costoso "per sicurezza" è il modo comune per spendere troppo.
Come usare Gemini 4 Neon senza scrivere codice?
Il percorso che ottieni dipende dal tuo piano. Al 21 novembre 2026, Google elenca questi luoghi in cui Neon è disponibile:
- L'app Gemini, per gli abbonati Pro e Ultra.
- Gemini for business, tramite il menu a tendina dei modelli. La disponibilità dipende dal tuo piano e dalle impostazioni dell'amministratore.
- Google AI Studio e l'API Gemini, solo al livello a pagamento. Google afferma che Neon non è disponibile al livello gratuito.
- Google Antigravity, per gli abbonati paganti ad AI Pro e Ultra.
Dove si colloca Runable
Se non vuoi gestire chiavi API, selezione del modello o fatturazione per token, una piattaforma di agenti è un'altra strada. Runable è il nostro prodotto: descrivi il risultato finale di cui hai bisogno, come 15 descrizioni di prodotti, un brief sulla concorrenza, una presentazione o un foglio di calcolo pulito, e lui pianifica il flusso di lavoro e restituisce il lavoro completato. Utilizzi il piano e i crediti di Runable anziché ricevere una fattura API Gemini separata.
Runable ha un livello gratuito, con Pro a 20 $ al mese a novembre 2026. Non abbiamo testato Neon all'interno di Runable e questo articolo non afferma che Runable lo utilizzi attualmente. Il confronto è tra la gestione autonoma delle API del modello e l'utilizzo di una piattaforma di agenti basata sui risultati.
Il punto pratico: il prezzo di 3 di Neon è facile da permettersi per lavori occasionali ad alta posta in gioco e vale la pena testarlo prima di usarlo per grandi volumi. La questione rimanente è il flusso di lavoro, non solo il prezzo.
FAQ
Cosa significano 3 nel prezzo di Gemini 4 Neon?
Significa 3 per milione di token di output (testo che genera, inclusi i token di riflessione). Un milione di token equivale a circa 750.000 parole, quindi una breve attività lavorativa come un'email costa circa mezzo centesimo a queste tariffe, prima di qualsiasi token di riflessione.
Gemini 4 Neon è gratuito da usare?
Non tramite l'API. Google afferma che Neon non è disponibile nel livello gratuito dell'API Gemini e l'utilizzo dell'API viene fatturato a 3 per milione di token. Gli abbonati paganti a Google AI Pro e Ultra possono utilizzarlo nell'app Gemini e in Antigravity, quindi l'accesso dipende dal tuo piano.
Gemini 4 Neon modifica i prezzi di Google Workspace?
Il prezzo dell'API non modifica direttamente il tuo abbonamento Workspace. La disponibilità di Neon dipende dal tuo piano Google, dal prodotto e dalle impostazioni dell'amministratore, quindi verifica con il tuo amministratore.
Gemini 4 Neon è migliore di GPT-6.2 o Claude Sonnet 5.5 per le piccole imprese?
Dipende dal lavoro. Per token, Neon (3 ) costa più di Claude Sonnet 5.5 e GPT-6.2 Sol (entrambi 2 ) e meno di GPT-6.2 Astra (8 ). Google afferma che Neon è più economico per attività rispetto ad alcuni modelli di frontiera, ma questa è l'affermazione di Google. Testa due o tre modelli sulle tue attività e confronta i conteggi totali dei token.
Quanto sono più economici Batch e l'input memorizzato nella cache?
Batch e Flex costano la metà del prezzo standard (1,50 in uscita per milione di token). L'input memorizzato nella cache costa 0,15 $ per milione di token, uno sconto del 95% sull'input, solo con memorizzazione nella cache implicita.
Letture correlate
- Agente IA Gemini di Google per Workspace: Guida PMI 2026
- Strumenti IA per le piccole imprese: 10 migliori nel 2026 (Testati)
- Migliori agenti IA per le piccole imprese nel 2026 (Per categoria)
- Automazione IA per le piccole imprese: cosa automatizzare per primo
- IA per il marketing delle piccole imprese: 10 modi per usarla nel 2026
- Migliori agenti IA nel 2026: 12 scelte in base al lavoro da svolgere
Salta la matematica dei token: descrivi l'attività e lascia che Runable faccia il lavoro
Gemini 4 Neon non sarà l'ultima modifica ai prezzi di quest'anno e tracciare i prezzi per token tra i fornitori non è un lavoro utile per la maggior parte delle aziende. Runable trasforma una richiesta in inglese semplice in una presentazione finita, un brief di ricerca, un sito web, una campagna email o un foglio di calcolo pulito. Inizia dal livello gratuito, forniscigli un'attività reale della tua settimana e valuta l'output completato, non la matematica dei token.

