Tarification de Gemini 4 Neon : ce que signifient les 3 $/15 $ pour votre entreprise
Points clés
- Gemini 4 Neon coûte 3 par million de jetons de sortie, avec une fenêtre de contexte d'un million de jetons. Google le positionne pour le codage complexe, le raisonnement analytique et les flux de travail en entreprise de niveau production, et non comme un modèle bon marché pour un usage quotidien. Les prix ci-dessous sont valables au 21 novembre 2026, trois jours après son lancement.
- Le chiffre de 3 correspond à la tarification de l'API et non au prix d'une licence Workspace. Cela ne modifie pas directement votre abonnement Workspace. La possibilité d'utiliser Neon dans les propres produits de Google dépend de votre forfait, du produit et des paramètres définis par votre administrateur.
- Neon ne figure pas dans le niveau gratuit de l'API. Les entrées mises en cache sont facturées 0,15 /7,50 $). Les jetons de réflexion sont facturés comme des jetons de sortie, donc une tâche qui « réfléchit » coûte plus cher que ce que suggère la réponse visible.
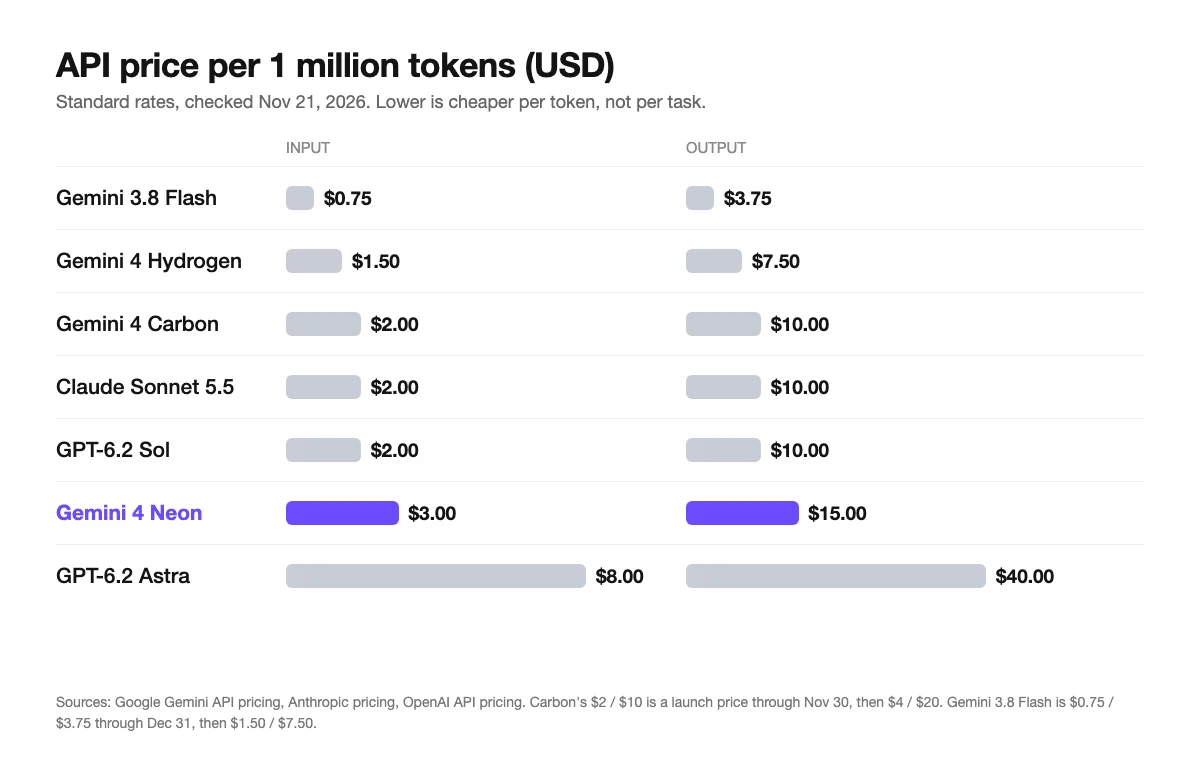
- Par jeton, Neon est plus coûteux que Claude Sonnet 5.5 et GPT-6.2 Sol d'OpenAI (tous deux à 2 ) et moins cher que GPT-6.2 Astra (8 ). Google affirme que Neon coûte environ 32 % de moins par tâche que Gemini 4 Carbon à son paramètre par défaut, et 50 % à 80 % de moins par tâche que certains modèles de pointe concurrents. Ce sont les chiffres de Google, considérez-les donc comme une affirmation à tester avec votre propre travail.
- Pour la plupart des tâches des petites entreprises, notre avis est qu'un modèle moins cher est un meilleur point de départ. Utilisez Neon là où une mauvaise réponse est coûteuse ou si l'entrée est très longue.
- Les entreprises qui ne souhaitent pas gérer des clés API ou une facturation par jeton peuvent utiliser une plateforme d'agents telle que Runable, qui fonctionne via des forfaits et des crédits. Runable est notre produit, et nous ne l'avons pas testé avec Neon.
Gemini 4 Neon en un coup d'œil : comment la tarification se compare
| Modèle | Entrée $/M jetons | Sortie $/M jetons | Notes |
|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | 1M de contexte. Payant uniquement. Entrée en cache 0,15 /7,50 $ |
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | Entrée en cache 0,075 $ |
| Gemini 4 Carbon | 2,00 $ | 10,00 $ | Prix de lancement jusqu'au 30 nov. 2026, puis 4 |
| Gemini 3.8 Flash | 0,75 $ | 3,75 $ | Jusqu'au 31 déc. 2026, puis 1,50 . Possède un niveau gratuit |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 1M de contexte |
| OpenAI GPT-6.2 Sol | 2,00 $ | 10,00 $ | Tarif standard |
| OpenAI GPT-6.2 Astra | 8,00 $ | 40,00 $ | Tarif standard |
Les prix correspondent aux tarifs API par million de jetons vérifiés le 21 novembre 2026, à partir de la page de tarification de l'API Gemini de Google, de la page Sonnet d'Anthropic et de la page de tarification de l'API d'OpenAI. Les fournisseurs modifient souvent ces prix, vérifiez-les donc avant de vous engager sur de gros volumes.
Qu'est-ce que Gemini 4 Neon et que signifient réellement les 3 ?
Gemini 4 Neon est un modèle de la famille Gemini 4 de Google, annoncé le 18 novembre 2026. Google le décrit comme apportant une intelligence de pointe à l'ingénierie logicielle complexe, au travail intellectuel et à la science, et son article de lancement le présente comme destiné au travail en entreprise, analytique et scientifique. Hydrogen, un niveau en dessous, est le modèle que Google propose pour le codage quotidien et les flux de travail basés sur les agents.
Le raccourci 3 fait référence aux deux tarifs par million de jetons. Les jetons d'entrée représentent tout ce que vous envoyez au modèle : votre invite, le document que vous y collez, la feuille de calcul qu'il lit. Les jetons de sortie sont tout ce qu'il rédige en retour. Les coûts de sortie sont plus élevés car la génération de texte nécessite plus de puissance de calcul que sa lecture.
En règle générale, un jeton représente environ les trois quarts d'un mot en anglais, donc un million de jetons correspond à environ 750 000 mots. La plupart des tâches des petites entreprises sont minuscules par rapport à cela. Un e-mail client avec 400 jetons en entrée et 250 jetons en sortie coûte environ 0,005 $, soit un demi-cent.
Un détail compte plus que le prix affiché. La page de tarification de Google indique que le tarif de sortie de 15 $ inclut les jetons de réflexion, et que chaque jeton traité par le modèle est compté et facturé, y compris les jetons de réflexion, les instructions système des outils internes et les déclarations de fonction lors de l'utilisation de la mise à la terre. La facture couvre donc bien plus que la réponse visible. Neon « réfléchit » avant de répondre, et vous payez pour cette réflexion même si vous ne la voyez jamais.
Comment Gemini 4 Neon se compare-t-il à Claude, GPT et aux autres modèles Gemini ?
En termes de prix affiché, Neon se situe au-dessus des modèles de milieu de gamme et en dessous du plus coûteux. Il coûte 50 % de plus que Claude Sonnet 5.5 et GPT-6.2 Sol tant en entrée qu'en sortie, et environ 60 % de moins que GPT-6.2 Astra.
Fenêtre de contexte. Neon possède une fenêtre de contexte d'un million de jetons. C'est également le cas de Claude Sonnet 5.5, donc un contexte long ne distingue plus Neon à lui seul. Cela signifie qu'un contrat long ou une boîte de réception complète peut être traité en une seule fois, ce qui évite le découpage.
Coût par tâche, pas par jeton. Google affirme qu'à son niveau de réflexion élevé par défaut, Neon coûte 32 % de moins par tâche que Gemini 4 Carbon, et environ 50 % à 80 % de moins par tâche que les meilleurs modèles de pointe concurrents. C'est l'affirmation de Google tirée de son article de lancement. Les tests indépendants sont plus nuancés. Artificial Analysis a attribué à Neon un score de 61 sur son indice d'intelligence à réflexion élevée, mais l'a qualifié de « quelque peu coûteux » par rapport à des modèles de prix similaire et a noté qu'il était lent et verbeux. Son chiffre de coût était de 6,44 $ par tâche sur son propre test de référence, ce qui n'est pas une tâche type de petite entreprise.
Classement. Au lancement, Google a cité Neon comme n°3 sur l'indice d'intelligence d'Artificial Analysis à réflexion élevée. Son classement en temps réel a depuis évolué (la page Artificial Analysis indiquait n°6 sur 95 le 21 novembre 2026), bien que son score reste de 61. Google a également rapporté un n°2 sur le Vals Index à 70,9 %. Les tests de référence mesurent des tâches de référence, donc un test sur vos propres documents vous en dira plus.
Le contrepoint honnête est que pour les invites courtes avec des réponses courtes (lignes d'objet, réponses de chat, classification), Gemini 3.8 Flash ou Hydrogen coûteront moins cher par tâche. Neon est conçu pour un travail plus difficile.
Qu'est-ce qui change pour les utilisateurs de Gemini pour entreprise et Workspace ?
Le prix de l'API ne modifie pas directement votre abonnement Workspace. La disponibilité de Neon dépend de votre forfait Google, du produit et des paramètres de votre administrateur.
Voici ce que Google a déclaré sur la disponibilité de Neon. Au lancement, il a été déployé dans l'API Gemini et Google AI Studio, dans Gemini pour entreprise (via l'API et le menu déroulant des modèles), pour les abonnés payants à Google AI Pro et Ultra dans Google Antigravity, et pour les abonnés Pro et Ultra dans l'application Gemini. Si vous avez un forfait entreprise, vérifiez auprès de votre administrateur avant de supposer que vous y avez accès.
La partie que la plupart des petites entreprises ressentiront est indirecte. Les outils et agents construits sur Gemini paient ces tarifs, donc le choix du modèle par un fournisseur affecte ses coûts. Que cela se traduise pour vous par des prix plus bas ou de meilleures fonctionnalités dépend de chaque fournisseur.
À surveiller au cours des prochains mois (nos attentes, pas des faits) :
- Les fournisseurs pourraient mettre à niveau discrètement. Les outils qui utilisaient un modèle moins coûteux pour contrôler les coûts pourraient passer aux modèles de classe Neon si le coût par tâche est viable.
- Les niveaux gratuits pourraient changer. Les modèles moins chers peuvent rendre les niveaux gratuits plus généreux, mais Neon lui-même n'a pas de niveau API gratuit aujourd'hui.
- La tarification de l'IA par siège pourrait être sous pression. Si le coût de calcul derrière le mois d'un utilisateur typique est de quelques dollars, une tarification fixe ou basée sur l'utilisation devient plus facile à justifier. Nous ne parierions pas sur le calendrier.
Combien coûtent les 3 par mois pour une petite entreprise ?
Cela dépend principalement de la réflexion du modèle, la réponse honnête est donc une fourchette. Les chiffres ci-dessous sont des calculs illustratifs basés sur les prix publiés par Google. Ce ne sont pas des résultats issus d'un test que nous avons effectué.
Coûts par tâche, en utilisant les tarifs standard de Neon de 3 en sortie :
- Court e-mail client (400 jetons en entrée, 250 en sortie) : environ **0,005 )
- Tâche moyenne (2 100 en entrée, 680 en sortie, comme une description de produit à partir d'une fiche technique) : environ **0,017 )
- Résumé de document long (52 000 en entrée, 3 800 en sortie, environ un contrat de 40 pages) : environ **0,21 )
Ils ne comptent que le texte visible. Les jetons de réflexion sont facturés au tarif de sortie, et les jetons liés aux outils tels que les déclarations de fonction et les instructions d'outils internes sont également facturés, donc les factures réelles sont plus élevées. Les documents de Google ne précisent pas le taux pour chaque jeton d'outil, vérifiez donc les nombres d'utilisation sur votre propre facture. Comme expérience de pensée, supposons 2 000 jetons de réflexion cachés pour la tâche moyenne. C'est notre hypothèse, pas une mesure. La tâche a alors 2 680 jetons de sortie et coûte environ 0,047 $.
Maintenant, passez à l'échelle d'un mois. Un exploitant individuel effectuant 20 tâches par jour pendant 22 jours réalise 440 tâches :
- Jetons visibles uniquement : environ 7,26 $
- Avec les 2 000 jetons de réflexion supposés par tâche : environ 20,46 $
- La même charge de travail sur Batch ou Flex (moitié prix, pour le travail qui peut attendre) : environ la moitié de l'un ou l'autre chiffre
L'utilisation réelle différera, et un travail de contexte long et soutenu, comme des milliers de pages de contrats ou un agent qui boucle plusieurs fois par travail, peut coûter beaucoup plus cher. L'entrée en cache à 0,15 $ par million de jetons aide lorsque vous envoyez le même document long à plusieurs reprises. Google note que seule la mise en cache implicite est prise en charge. Le moyen de connaître votre propre chiffre est d'exécuter une semaine de tâches réelles et de lire le nombre de jetons sur votre facture.
Quand devriez-vous utiliser Neon par rapport à Hydrogen ou Flash ?
C'est notre opinion, pas les conseils de Google. Utilisez le modèle le moins cher qui fait le travail, et passez au niveau supérieur lorsque la tâche est difficile ou qu'une erreur est coûteuse.
- Gemini 3.8 Flash (0,75 jusqu'au 31 déc., puis 1,50 ) : travail à haut volume et modélisé comme le marquage, les réponses courtes et l'extraction de données.
- Gemini 4 Hydrogen (1,50 ) : codage quotidien et flux de travail basés sur les agents, c'est ainsi que Google le positionne. Nous l'essaierions également en premier pour l'écriture et les résumés de routine, mais cette partie est notre opinion, pas celle de Google.
- Gemini 4 Neon (3 ) : analyse complexe, travail multi-documents long, codage et tout ce pour quoi une réponse bâclée vous coûte de l'argent ou de la réputation.
Testez avant de vous engager. Exécutez 10 de vos tâches réelles sur deux modèles, comparez la qualité et le nombre de jetons, puis décidez. Mettre par défaut chaque tâche sur le modèle le plus coûteux « pour être sûr » est le moyen courant de trop dépenser.
Comment utiliser Gemini 4 Neon sans écrire de code ?
Le chemin que vous empruntez dépend de votre forfait. Au 21 novembre 2026, Google répertorie les endroits où Neon est disponible :
- L'application Gemini, pour les abonnés Pro et Ultra.
- Gemini pour entreprise, via le menu déroulant des modèles. La disponibilité dépend de votre forfait et des paramètres de votre administrateur.
- Google AI Studio et l'API Gemini, uniquement sur le niveau payant. Google indique que Neon n'est pas disponible sur le niveau gratuit.
- Google Antigravity, pour les abonnés payants à AI Pro et Ultra.
Où s'inscrit Runable
Si vous ne souhaitez pas gérer des clés API, la sélection de modèles ou la facturation par jeton, une plateforme d'agents est une autre voie. Runable est notre produit : vous décrivez le résultat final dont vous avez besoin, comme 15 descriptions de produits, un dossier sur un concurrent, une présentation ou une feuille de calcul nettoyée, et il planifie le flux de travail et renvoie le travail terminé. Vous utilisez le plan et les crédits de Runable plutôt que de recevoir une facture d'API Gemini séparée.
Runable a un niveau gratuit, avec Pro à 20 $ par mois à partir de novembre 2026. Nous n'avons pas testé Neon dans Runable, et cet article ne prétend pas que Runable l'utilise actuellement. La comparaison se fait entre la gestion vous-même des API de modèles et l'utilisation d'une plateforme d'agents basée sur les résultats.
Le point pratique : le prix de 3 de Neon est facile à payer pour un travail occasionnel à enjeux élevés et mérite d'être testé avant de l'utiliser pour du volume. La question restante est le flux de travail, pas seulement le prix.
FAQ
Que signifient 3 dans la tarification de Gemini 4 Neon ?
Cela signifie 3 par million de jetons de sortie (texte qu'il génère, y compris les jetons de réflexion). Un million de jetons représente environ 750 000 mots, donc une tâche commerciale courte comme un e-mail coûte environ un demi-cent à ces tarifs, avant tout jeton de réflexion.
Gemini 4 Neon est-il gratuit ?
Pas via l'API. Google indique que Neon n'est pas disponible sur le niveau gratuit de l'API Gemini, et l'utilisation de l'API est facturée 3 par million de jetons. Les abonnés payants à Google AI Pro et Ultra peuvent l'utiliser dans l'application Gemini et Antigravity, l'accès dépend donc de votre forfait.
Gemini 4 Neon modifie-t-il la tarification de Google Workspace ?
Le prix de l'API ne modifie pas directement votre abonnement Workspace. La disponibilité de Neon dépend de votre forfait Google, du produit et des paramètres de votre administrateur, vérifiez donc auprès de votre administrateur.
Gemini 4 Neon est-il meilleur que GPT-6.2 ou Claude Sonnet 5.5 pour les petites entreprises ?
Cela dépend du travail. Par jeton, Neon (3 ) coûte plus cher que Claude Sonnet 5.5 et GPT-6.2 Sol (tous deux à 2 ) et moins cher que GPT-6.2 Astra (8 ). Google affirme que Neon est moins cher par tâche que certains modèles de pointe, mais c'est l'affirmation de Google. Testez deux ou trois modèles sur vos propres tâches et comparez le nombre total de jetons.
Combien coûtent moins cher Batch et l'entrée en cache ?
Batch et Flex coûtent la moitié du prix standard (1,50 en sortie par million de jetons). L'entrée en cache est à 0,15 $ par million de jetons, soit une remise de 95 % sur l'entrée, avec uniquement une mise en cache implicite.
Lectures associées
- Agent d'IA Google Gemini pour Workspace : Guide PME 2026
- Outils d'IA pour les petites entreprises : les 10 meilleurs en 2026 (testés)
- Meilleurs agents d'IA pour les petites entreprises en 2026 (par catégorie)
- Automatisation par l'IA pour les petites entreprises : quoi automatiser en premier
- L'IA pour le marketing des petites entreprises : 10 façons de l'utiliser en 2026
- Meilleurs agents d'IA en 2026 : 12 choix selon le travail que vous devez accomplir
Oubliez le calcul des jetons : décrivez la tâche et laissez Runable faire le travail
Gemini 4 Neon ne sera pas le dernier changement de prix cette année, et suivre les prix par jeton entre les fournisseurs n'est pas un travail utile pour la plupart des entreprises. Runable transforme une demande en langage courant en un deck fini, un dossier de recherche, un site Web, une campagne d'e-mailing ou une feuille de calcul nettoyée. Commencez sur le niveau gratuit, confiez-lui une tâche réelle de votre semaine et jugez le résultat final, pas le calcul des jetons.

