Precios de Gemini 4 Neon: lo que significan $3/$15 para su empresa
Puntos clave
- Gemini 4 Neon cuesta $3 por millón de tokens de entrada y $15 por millón de tokens de salida, con una ventana de contexto de 1 millón de tokens. Google lo posiciona para tareas complejas de programación, razonamiento analítico y flujos de trabajo empresariales de producción, no como un modelo barato para uso diario. Los precios a continuación son al 21 de noviembre de 2026, tres días después del lanzamiento.
- La cifra de $3/$15 es el precio de la API, no el precio por asiento de Workspace. No cambia directamente su suscripción a Workspace. Si puede usar Neon en los productos de Google depende de su plan, el producto y la configuración de su administrador.
- Neon no está en el nivel gratuito de la API. La entrada en caché cuesta $0,15 por millón de tokens, y los modos Batch y Flex cuestan la mitad ($1,50/$7,50). Los tokens de pensamiento se facturan como salida, por lo que una tarea que "piensa" cuesta más de lo que sugiere la respuesta visible.
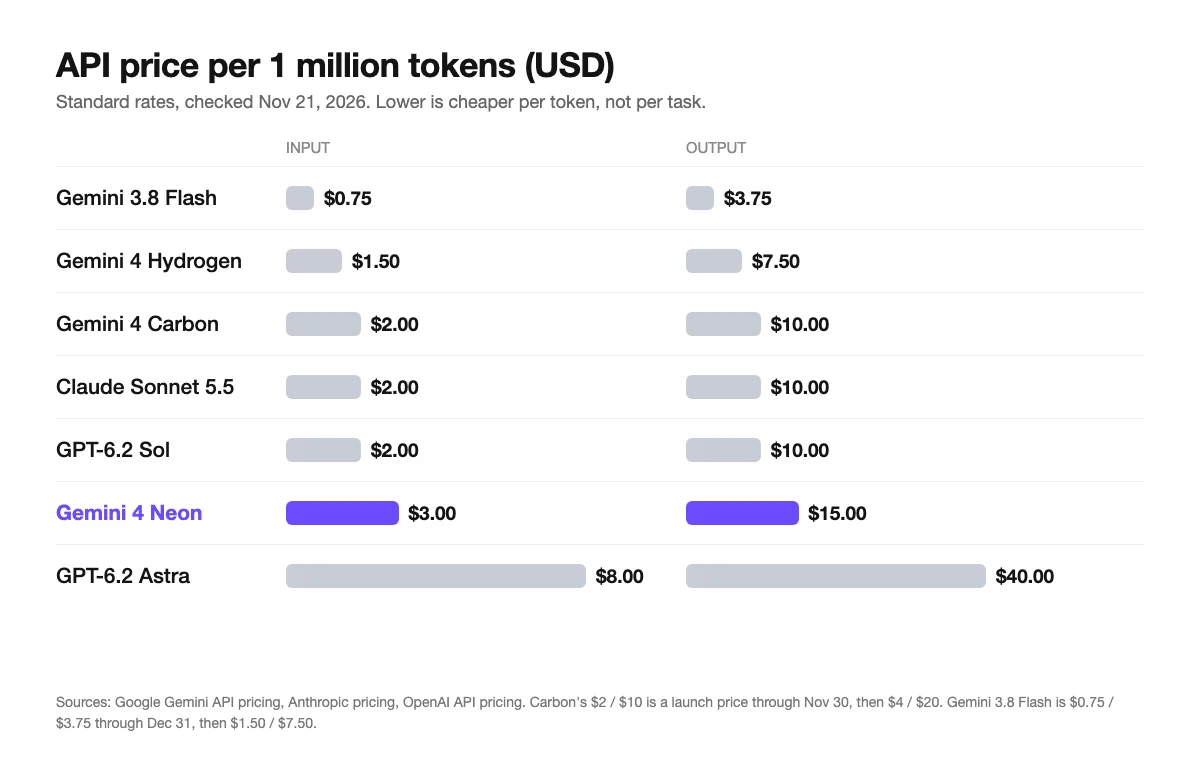
- Por token, Neon es más caro que Claude Sonnet 5.5 y GPT-6.2 Sol de OpenAI (ambos $2/$10) y más barato que GPT-6.2 Astra ($8/$40). Google dice que Neon cuesta aproximadamente un 32% menos por tarea que Gemini 4 Carbon en su configuración predeterminada, y entre un 50% y un 80% menos por tarea que algunos modelos fronterizos de la competencia. Esas son las cifras de Google, así que considérelas como una afirmación que debe probar con su propio trabajo.
- Para la mayoría de las tareas de pequeñas empresas, opinamos que un modelo más barato es el mejor punto de partida. Use Neon cuando una respuesta incorrecta sea costosa o la entrada sea muy larga.
- Las empresas que no quieran gestionar claves de API o facturación por token pueden utilizar una plataforma de agentes como Runable, que funciona mediante planes y créditos. Runable es nuestro producto y no hemos probado Neon dentro de él.
Gemini 4 Neon de un vistazo: cómo se comparan los precios
| Modelo | Entrada $/M tokens | Salida $/M tokens | Notas |
|---|---|---|---|
| Gemini 4 Neon | $3,00 | $15,00 | 1M contexto. Solo pago. Entrada en caché $0,15. Batch y Flex $1,50/$7,50 |
| Gemini 4 Hydrogen | $1,50 | $7,50 | Entrada en caché $0,075 |
| Gemini 4 Carbon | $2,00 | $10,00 | Precio de lanzamiento hasta el 30 de noviembre de 2026, luego $4/$20 |
| Gemini 3.8 Flash | $0,75 | $3,75 | Hasta el 31 de diciembre de 2026, luego $1,50/$7,50. Tiene un nivel gratuito |
| Claude Sonnet 5.5 | $2,00 | $10,00 | 1M contexto |
| OpenAI GPT-6.2 Sol | $2,00 | $10,00 | Tarifa estándar |
| OpenAI GPT-6.2 Astra | $8,00 | $40,00 | Tarifa estándar |
Los precios son las tarifas de API por millón de tokens verificadas el 21 de noviembre de 2026, desde la página de precios de la API de Gemini de Google, la página de Sonnet de Anthropic y la página de precios de la API de OpenAI. Los proveedores cambian estos precios con frecuencia, así que verifíquelos antes de comprometerse a grandes volúmenes.
¿Qué es Gemini 4 Neon y qué significa realmente $3/$15?
Gemini 4 Neon es un modelo de la familia Gemini 4 de Google, anunciado el 18 de noviembre de 2026. Google lo describe como un modelo que aporta inteligencia de nivel fronterizo a la ingeniería de software compleja, el trabajo de conocimiento y la ciencia, y su artículo de lanzamiento lo orienta al trabajo empresarial, analítico y científico. Hydrogen, un nivel por debajo, es el modelo que Google propone para la programación diaria y los flujos de trabajo con agentes.
La abreviatura $3/$15 se refiere a las dos tarifas por millón de tokens. Los tokens de entrada son todo lo que envía al modelo: su instrucción, el documento que pega, la hoja de cálculo que lee. Los tokens de salida son todo lo que escribe de vuelta. La salida cuesta más porque generar texto requiere más cómputo que leerlo.
Como regla general, un token equivale aproximadamente a tres cuartas partes de una palabra en inglés, por lo que un millón de tokens son aproximadamente 750 000 palabras. La mayoría de las tareas de pequeñas empresas son minúsculas comparadas con eso. Un correo electrónico de cliente con 400 tokens de entrada y 250 de salida cuesta unos $0,005, es decir, medio centavo.
Un detalle importa más que el precio de etiqueta. La página de precios de Google dice que la tarifa de salida de $15 incluye tokens de pensamiento, y que cada token que procesa el modelo se cuenta y factura, incluidos los tokens de pensamiento y las instrucciones internas del sistema de herramientas y las declaraciones de funciones cuando se usa conexión a tierra. Por lo tanto, la factura cubre más que la respuesta visible. Neon "piensa" antes de responder, y usted paga por ese pensamiento aunque nunca lo vea.
¿Cómo se compara Gemini 4 Neon con Claude, GPT y otros modelos Gemini?
En cuanto a precio, Neon se sitúa por encima de los modelos de nivel medio y por debajo del más caro. Cuesta un 50% más que Claude Sonnet 5.5 y GPT-6.2 Sol tanto en entrada como en salida, y aproximadamente un 60% menos que GPT-6.2 Astra.
Ventana de contexto. Neon tiene una ventana de contexto de 1 millón de tokens. Lo mismo ocurre con Claude Sonnet 5.5, por lo que un contexto largo por sí solo ya no distingue a Neon. Sí significa que un contrato largo o una bandeja de entrada llena pueden procesarse en una sola pasada, lo que evita la fragmentación.
Costo por tarea, no por token. Google dice que, en su nivel de pensamiento alto predeterminado, Neon cuesta un 32% menos por tarea que Gemini 4 Carbon, y aproximadamente entre un 50% y un 80% menos por tarea que los principales modelos fronterizos de la competencia. Esa es la afirmación de Google en su artículo de lanzamiento. Las pruebas independientes son más variadas. Artificial Analysis otorgó a Neon un 61 en su Índice de Inteligencia con pensamiento xhigh, pero lo calificó de "algo caro" en comparación con modelos de precio similar y señaló que era lento y detallado. Su cifra de costo fue de $6,44 por tarea en su propio punto de referencia, lo cual no es una tarea típica de una pequeña empresa.
Dónde se clasifica. En el lanzamiento, Google citó a Neon como el n.º 3 en el Índice de Inteligencia de Artificial Analysis en xhigh. Su clasificación en tiempo real ha cambiado desde entonces (la página de Artificial Analysis mostraba el n.º 6 de 95 el 21 de noviembre de 2026), aunque su puntuación sigue siendo 61. Google también informó el n.º 2 en el Índice Vals con un 70,9%. Los puntos de referencia miden tareas de referencia, por lo que una prueba con sus propios documentos le dirá más.
El contrapunto honesto es que para instrucciones breves con respuestas cortas (asuntos, respuestas de chat, clasificación), Gemini 3.8 Flash o Hydrogen costarán menos por tarea. Neon está diseñado para trabajos más difíciles.
¿Qué cambia para los usuarios de Gemini for business y Workspace?
El precio de la API no cambia directamente su suscripción a Workspace. La disponibilidad de Neon depende de su plan de Google, el producto y la configuración del administrador.
Esto es lo que Google ha dicho sobre dónde está disponible Neon. En el lanzamiento, se implementó en la API de Gemini y Google AI Studio, en Gemini for business (a través de la API y el menú desplegable del modelo), para suscriptores de pago de Google AI Pro y Ultra en Google Antigravity, y para suscriptores de Pro y Ultra en la aplicación Gemini. Si tiene un plan empresarial, consulte con su administrador antes de asumir que lo tiene.
La parte que más notarán las pequeñas empresas es indirecta. Las herramientas y los agentes creados en Gemini pagan estas tarifas, por lo que la elección del modelo por parte de un proveedor afecta sus costos. Si eso llega a usted como precios más bajos o mejores funciones depende de cada proveedor.
Qué observar en los próximos meses (nuestras expectativas, no hechos):
- Los proveedores pueden actualizar silenciosamente. Las herramientas que utilizaban un modelo más barato para controlar los costos podrían pasar a modelos de clase Neon si el costo por tarea resulta rentable.
- Los niveles gratuitos podrían cambiar. Los modelos más baratos pueden hacer que los niveles gratuitos sean más generosos, pero Neon en sí no tiene un nivel gratuito de API hoy en día.
- El precio por asiento de IA puede enfrentar presión. Si el cómputo detrás del mes de un usuario típico es de unos pocos dólares, el precio fijo o basado en el uso se vuelve más fácil de justificar. No apostaríamos por los tiempos.
¿Cuánto cuesta $3/$15 al mes para una pequeña empresa?
Depende principalmente de cuánto piense el modelo, por lo que la respuesta honesta es un rango. Las cifras a continuación son cálculos ilustrativos de los precios publicados por Google. No son resultados de una prueba que hayamos realizado.
Costos por tarea, utilizando las tarifas estándar de Neon de $3 de entrada y $15 de salida:
- Correo electrónico corto de cliente (400 tokens de entrada, 250 de salida): aproximadamente $0,005 ($0,00495)
- Tarea mediana (2100 de entrada, 680 de salida, como una descripción de producto a partir de una hoja de especificaciones): aproximadamente $0,017 ($0,0165)
- Resumen de documento largo (52 000 de entrada, 3800 de salida, aproximadamente un contrato de 40 páginas): aproximadamente $0,21 ($0,213)
Estos cuentan solo el texto visible. Los tokens de pensamiento se facturan a la tarifa de salida, y los tokens relacionados con herramientas como declaraciones de funciones e instrucciones internas de herramientas también se facturan, por lo que las facturas reales son más altas. Los documentos de Google no especifican la tarifa para cada token de herramienta, así que revise los conteos de uso en su propia factura. Como experimento mental, suponga 2000 tokens de pensamiento ocultos en la tarea mediana. Esa es nuestra suposición, no una medición. La tarea entonces tiene 2680 tokens de salida y cuesta aproximadamente $0,047.
Ahora escale a un mes. Un operador independiente que realiza 20 tareas al día durante 22 días realiza 440 tareas:
- Solo tokens visibles: aproximadamente $7,26
- Con los 2000 tokens de pensamiento supuestos por tarea: aproximadamente $20,46
- La misma carga de trabajo en Batch o Flex (mitad de precio, para trabajos que pueden esperar): aproximadamente la mitad de cualquiera de las dos cifras
El uso real diferirá, y el trabajo sostenido de contexto largo, como miles de páginas de contratos o un agente que se repite muchas veces por trabajo, puede costar mucho más. La entrada en caché a $0,15 por millón de tokens ayuda cuando envía el mismo documento largo repetidamente. Google señala que solo se admite el almacenamiento en caché implícito. La forma de conocer su propio número es ejecutar una semana de tareas reales y leer los conteos de tokens en su factura.
¿Cuándo debería usar Neon versus Hydrogen versus Flash?
Esta es nuestra opinión, no una guía de Google. Use el modelo más barato que realice el trabajo y suba de nivel cuando la tarea sea difícil o un error sea costoso.
- Gemini 3.8 Flash ($0,75/$3,75 hasta el 31 de diciembre, luego $1,50/$7,50): trabajo de gran volumen y con plantillas, como etiquetado, respuestas cortas y extracción de datos.
- Gemini 4 Hydrogen ($1,50/$7,50): programación diaria y flujos de trabajo con agentes, que es como Google lo posiciona. También lo probaríamos primero para escritura rutinaria y resúmenes, pero esa parte es nuestra opinión, no la de Google.
- Gemini 4 Neon ($3/$15): análisis complejo, trabajo con múltiples documentos largos, programación y cualquier cosa en la que una respuesta descuidada le cueste dinero o reputación.
Pruebe antes de comprometerse. Ejecute 10 de sus tareas reales en dos modelos, compare la calidad y los conteos de tokens, y luego decida. Dejar cada tarea en el modelo más caro "por seguridad" es la forma común de gastar de más.
¿Cómo puede usar Gemini 4 Neon sin escribir ningún código?
Qué ruta obtenga depende de su plan. A partir del 21 de noviembre de 2026, Google enumera estos lugares donde Neon está disponible:
- La aplicación Gemini, para suscriptores de Pro y Ultra.
- Gemini for business, a través del menú desplegable del modelo. La disponibilidad depende de su plan y la configuración de su administrador.
- Google AI Studio y la API de Gemini, solo en el nivel de pago. Google dice que Neon no está disponible en el nivel gratuito.
- Google Antigravity, para suscriptores de pago de AI Pro y Ultra.
Dónde encaja Runable
Si no desea administrar claves de API, selección de modelos o facturación por token, una plataforma de agentes es otra ruta. Runable es nuestro producto: usted describe el resultado final que necesita, como 15 descripciones de productos, un resumen de la competencia, una presentación o una hoja de cálculo limpia, y este planifica el flujo de trabajo y devuelve el trabajo completado. Usted usa el plan y los créditos de Runable en lugar de recibir una factura de API de Gemini por separado.
Runable tiene un nivel gratuito, con Pro a $20 al mes a partir de noviembre de 2026. No hemos probado Neon dentro de Runable, y este artículo no afirma que Runable lo use actualmente. La comparación es entre administrar las API de modelos usted mismo y usar una plataforma de agentes basada en resultados.
La conclusión práctica: el precio de $3/$15 de Neon es fácil de pagar para trabajos ocasionales de alto riesgo y vale la pena probarlo antes de usarlo para grandes volúmenes. La pregunta restante es el flujo de trabajo, no solo el precio.
Preguntas frecuentes
¿Qué significa $3/$15 en el precio de Gemini 4 Neon?
Significa $3 por millón de tokens de entrada (texto que envía al modelo) y $15 por millón de tokens de salida (texto que genera, incluidos los tokens de pensamiento). Un millón de tokens equivale aproximadamente a 750 000 palabras, por lo que una tarea comercial corta como un correo electrónico cuesta aproximadamente medio centavo a estas tarifas, antes de cualquier token de pensamiento.
¿Es Gemini 4 Neon de uso gratuito?
No a través de la API. Google dice que Neon no está disponible en el nivel gratuito de la API de Gemini, y el uso de la API se factura a $3/$15 por millón de tokens. Los suscriptores de pago de Google AI Pro y Ultra pueden usarlo en la aplicación Gemini y Antigravity, por lo que el acceso depende de su plan.
¿Cambia Gemini 4 Neon el precio de Google Workspace?
El precio de la API no cambia directamente su suscripción a Workspace. La disponibilidad de Neon depende de su plan de Google, el producto y la configuración del administrador, así que consulte con su administrador.
¿Es Gemini 4 Neon mejor que GPT-6.2 o Claude Sonnet 5.5 para pequeñas empresas?
Depende del trabajo. Por token, Neon ($3/$15) cuesta más que Claude Sonnet 5.5 y GPT-6.2 Sol (ambos $2/$10) y menos que GPT-6.2 Astra ($8/$40). Google dice que Neon es más barato por tarea que algunos modelos fronterizos, pero esa es la afirmación de Google. Pruebe dos o tres modelos en sus propias tareas y compare los conteos totales de tokens.
¿Cuánto más baratos son Batch y la entrada en caché?
Batch y Flex son la mitad del precio estándar ($1,50 de entrada, $7,50 de salida por millón de tokens). La entrada en caché cuesta $0,15 por millón de tokens, un 95% de descuento en la entrada, solo con almacenamiento en caché implícito.
Lectura relacionada
- Agente de IA de Google Gemini para Workspace: Guía para pequeñas empresas 2026
- Herramientas de IA para pequeñas empresas: las 10 mejores en 2026 (probadas)
- Los mejores agentes de IA para pequeñas empresas en 2026 (por categoría)
- Automatización de IA para pequeñas empresas: qué automatizar primero
- IA para marketing de pequeñas empresas: 10 formas de usarla en 2026
- Los mejores agentes de IA en 2026: 12 selecciones según el trabajo que necesita realizar
Omita las matemáticas de los tokens: describa la tarea y deje que Runable haga el trabajo
Gemini 4 Neon no será el último cambio de precio este año, y realizar un seguimiento de los precios por token entre proveedores no es un trabajo útil para la mayoría de las empresas. Runable convierte una solicitud en lenguaje sencillo en una plataforma final, resumen de investigación, sitio web, campaña de correo electrónico u hoja de cálculo limpia. Comience en el nivel gratuito, entréguele una tarea real de su semana y juzgue el resultado completado, no las matemáticas de los tokens.

